开源文档解析能替代商业方案吗?先算清生产落地这笔账-合合信息解决方案
“直接下个开源文档解析模型不就行了?”面对企业文档解析、PDF转结构化数据的需求时,这成了很多技术人员、采购决策者的第一反应。近两年,开源文档工具能力从基础文字识别延伸到版面检测、表格还原等逻辑解析环节,公开测试榜单最优成绩(简称SOTA,即当前公开方案最高精度水平)频频刷新,更让不少团队默认“开源自建性价比更高”。
但真把业务里的扫描研报、跨页合同、百页招股书丢进开源模型时,串页、丢表、阅读顺序混乱等问题往往层出不穷。这其中核心的误区很简单:大家把开源开放的模型权重,直接等同于可稳定运行的生产产线。然而在实际业务场景中,文档解析选型真实生产场景的可用性、落地成本与责任边界才是决策核心,成熟商业文档解析服务往往是更稳妥的选择。
开源刷榜高分,为什么撑不起生产需求?
一些主流开源项目往往在公开标准评测集上能刷出高分;但在实际业务中,这类模型不经业务数据微调、直接落地企业真实复杂文档时,复杂表格、跨页续表等场景的解析质量通常会出现明显落差,通用OCR与版面模型跨场景落地企业真实业务时,也大多存在10-25个百分点的精度回退。
这里的落差核心来自两点:一是榜单样本均经过标准化清洗,多为排版规整的电子文档,而企业真实文档普遍存在低清扫描畸变、双栏绕排、跨页续表、脚注混杂等复杂情况,数据分布差异极大;二是开源开放的是单点模型权重,而非开箱即用的完整产线,企业要自行承担三类隐形成本:
拼接成本:需自行串联版面检测、逻辑排序、表格还原、元素分类等多个模块,适配复杂排版需要算法团队长期调优;
运维成本:要同时搭建GPU推理集群、CPU业务调度栈,配专人负责负载均衡、异常兜底、批量调度与故障排查;
风险成本:开源协议仅开放能力使用权,不承诺生产可用性,解析错误、服务宕机造成的业务损失全部由企业自担,也无标准化溯源机制。
所以,对于企业团队来说,判断一套方案能不能进生产,与其纠结复杂榜单参数,还应重点关注这些可量化的硬指标,即长文档复杂场景覆盖度、解析结果可溯源、批量运行一致性与全周期总体拥有成本。
合合信息TextIn xParse:开箱即用的生产级文档解析方案
合合信息TextIn xParse正是针对生产场景打造的商业文档解析产品,把模型能力、工程链路、责任兜底全部封装完成,企业无需自行拼装调优,开箱即可获得从文档输入到结构化输出的完整能力,直接覆盖上述三类核心选型要求。
全链路原生整合,复杂场景直接可用
xParse无需企业自行开发拼接逻辑,原生支持PDF转结构化数据,可输出Markdown、JSON两种通用格式,覆盖版面分析、阅读顺序还原、表格结构还原、16类文档元素识别全解析环节。
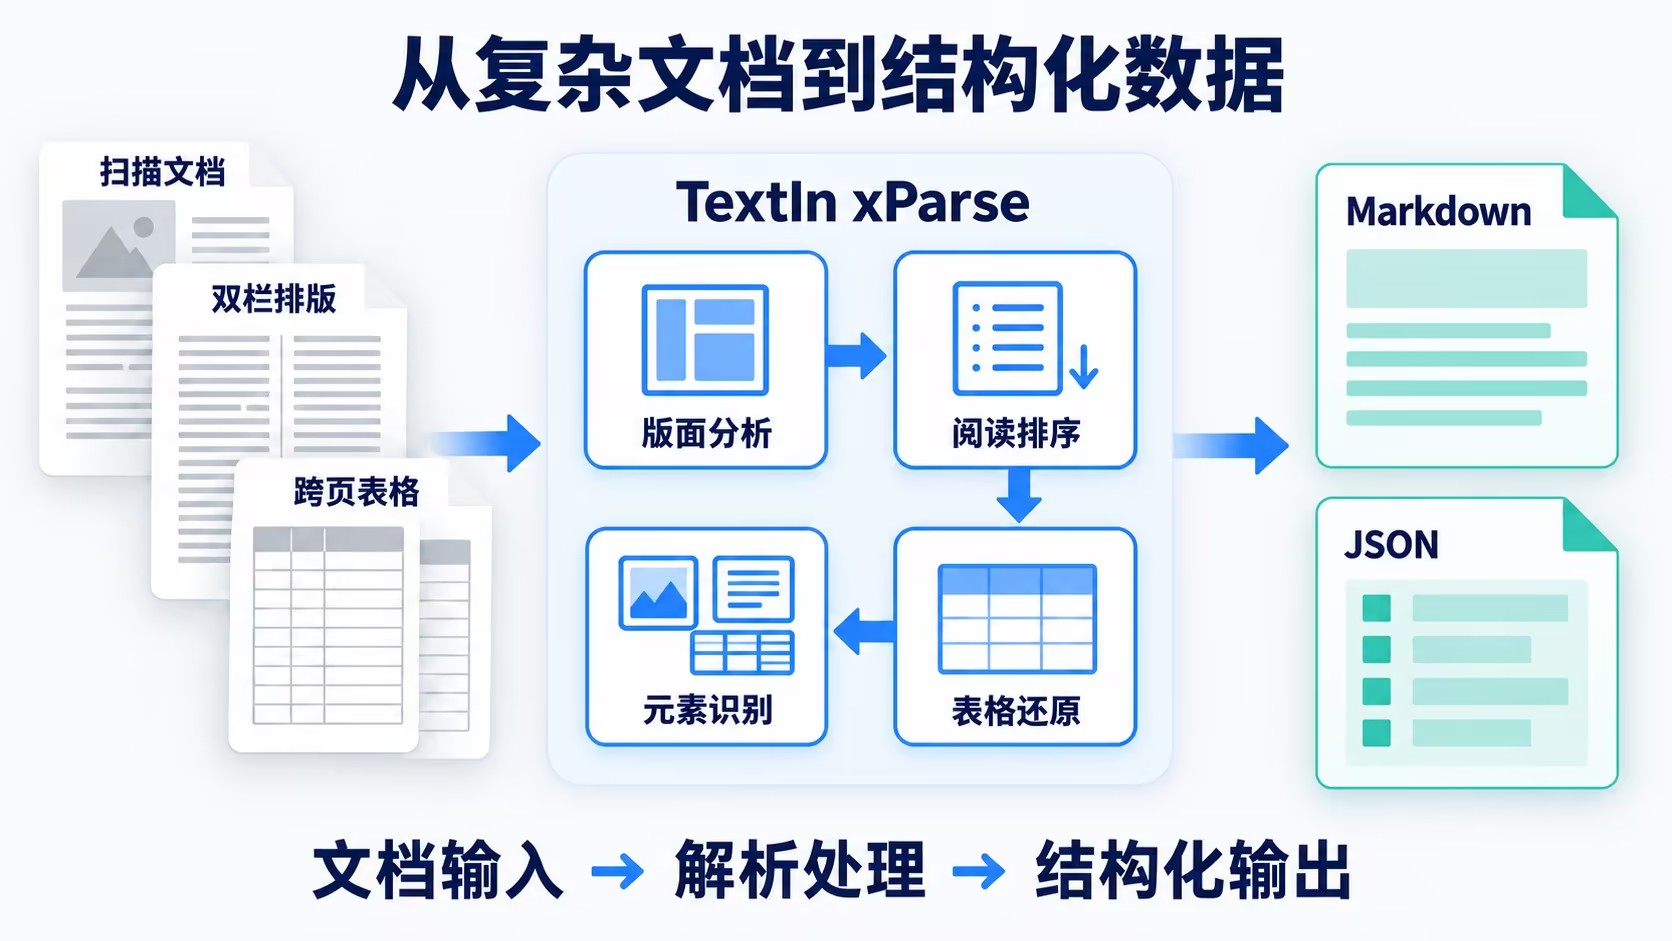
针对开源模型最容易出错的复杂排版,xParse并非简单按坐标生硬排序元素,而是结合版面语义、章节关联与大众阅读习惯做全局逻辑排序,双栏论文、绕排图文、跨页章节等场景均可输出符合认知逻辑的内容;表格以树形结构存储结果,完整保留合并单元格、跨页续表、嵌套表格的层级关系。官方标称标准场景下文字识别准确率达99.77%,表格识别率超过99%,综合版面还原度达95%,企业无需额外编写大量正则做后处理。
同时它可自动区分标题、正文、图片、表格、页眉页脚、脚注尾注、公式、水印等16类文档元素,避免注释、水印等无效内容混入下游业务,适配合同、研报、招股书、扫描档案等绝大多数企业常见文档类型。
全字段坐标溯源,满足合规与RAG需求
针对生产场景的结果校验要求,xParse所有输出内容均附带页面、段落、字符级的原文坐标,可直接跳转回原文对应位置核对,解析结果均可溯源校验,不存在无法验证的黑盒置信度。
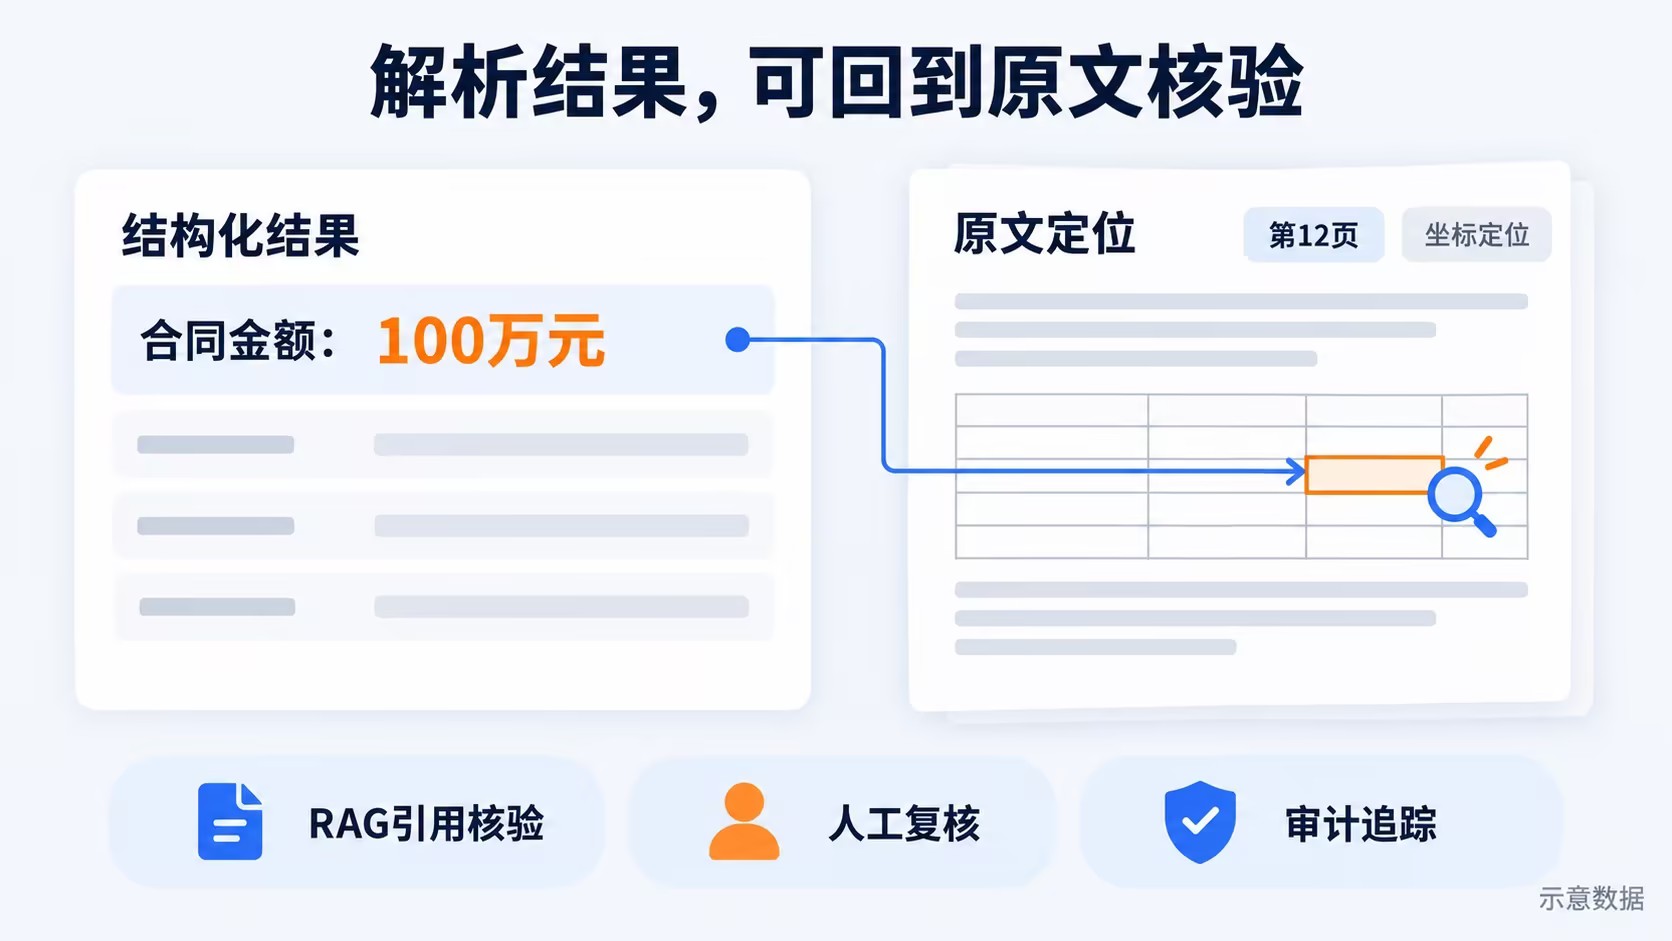
这套溯源能力天然适配RAG、合规审计、大模型训练数据处理等场景:一旦下游输出内容有误,运营或合规人员可快速定位原文出处,从输入层降低大模型幻觉风险,也满足金融、政务等强监管行业的内容审计要求。
高性能多形态部署,企业级服务有兜底
在性能层面,xParse对于百页文档的解析可快至1.5秒,还可支撑实时交互类业务;单批次500万页的大规模处理任务能够在3天内完成,适配企业存量档案数字化、批量训练数据集构建需求;服务调用成功率达99.9%,配套全链路异常监控、自动重试、失败兜底机制,低清、畸变等边缘异常文档也不会引发批量故障。
部署层面,xParse支持云端API、SDK、私有化部署、端侧SDK多种形态,企业可根据数据合规要求、业务规模灵活选择。和开源方案“风险自担”的属性不同,TextIn xParse提供标准化企业级SLA,服务可用性、故障响应时效、问题兜底均有明确约定,可有效缩短项目上线周期。
以券商投研典型场景为例,券商机构批量解析存量上市研报、搭建投研RAG知识库时,可以接入合合信息TextIn xParse,从而获得格式统一、可溯源的结构化输出结果,且跨页表格完整、批量输出稳定,直接满足投研内容的合规校验要求,节省自建团队的高额人力与时间成本。
选型建议:用真实文档做三组快速自测
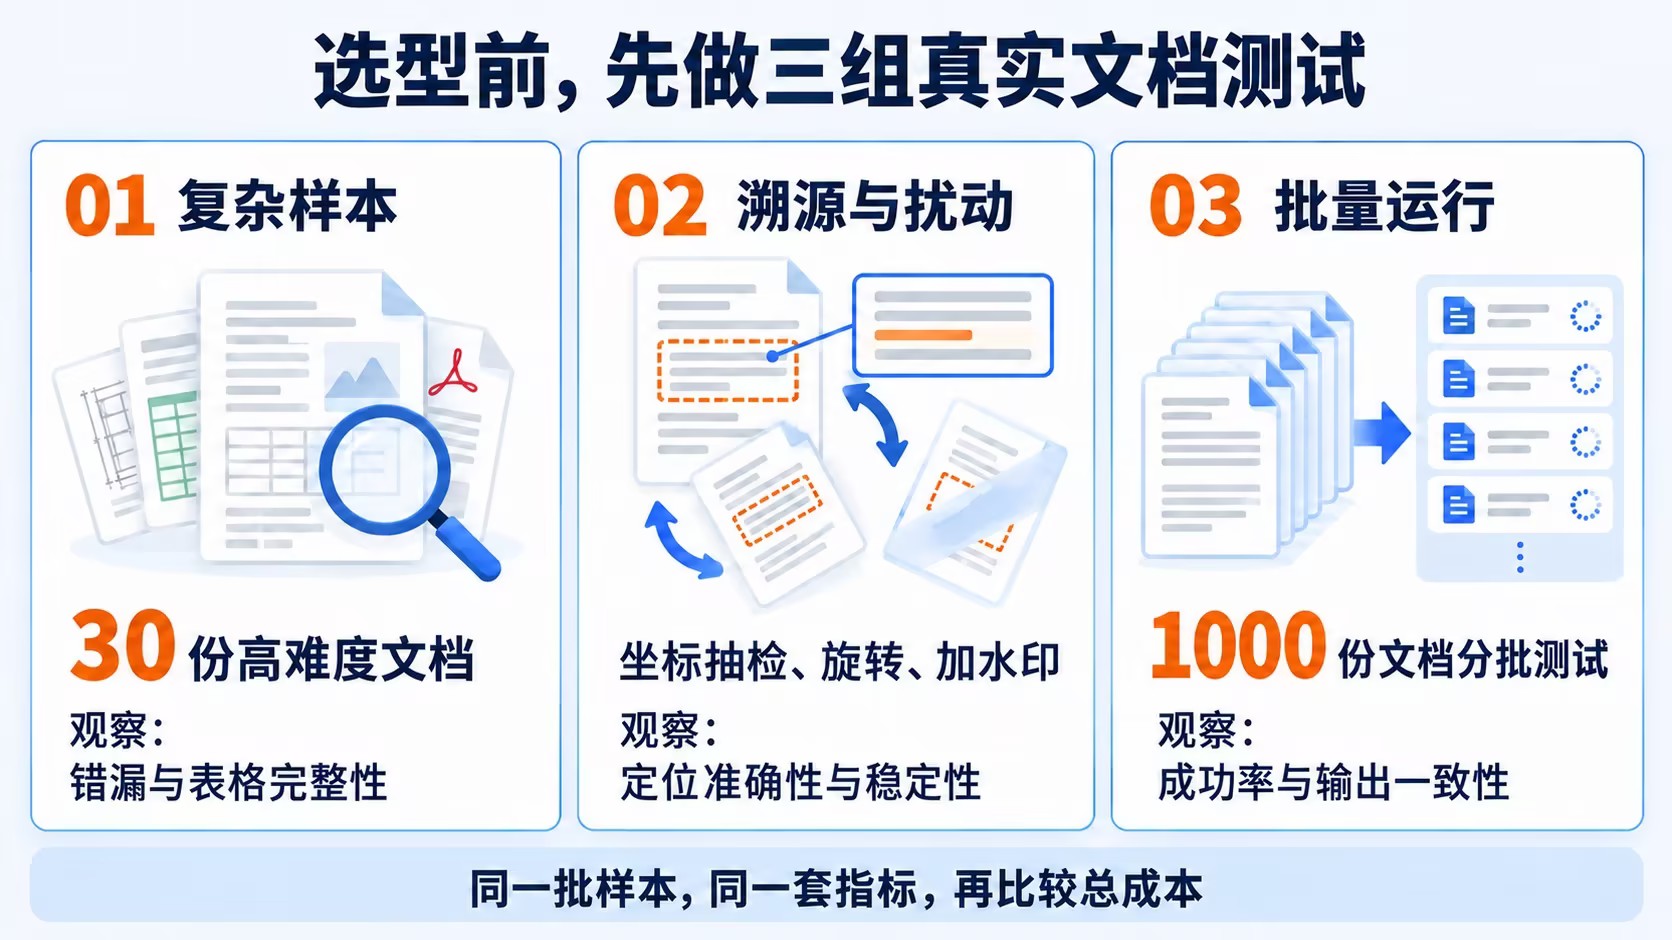
如果团队仍在评估开源方案,可以直接拿业务真实文档进行测试:抽取30份低清、多跨页、排版最复杂的极端样本,统计错漏率验证场景覆盖度;抽检解析结果的坐标溯源能力,对文档做旋转、加水印处理后复测稳定性;拿千份同格式文档分批跑测,统计批量成功率。
综上,在本质上,开源模型降低了技术探索的门槛,但未降低企业级落地的综合成本。企业的文档解析选型。选的不只是一个高精度模型文件,更是一套稳定、可控、可兜底的生产能力。对于没有文档解析技术团队的企业而言,成熟的商业文档解析投入产出比往往更高,也能更快支撑业务落地。