大模型发展到2026年,当模型差距收窄,企业AI为何更依赖文档解析?
很多企业引入大模型后,仍会遇到“资料找到了,答案却不可靠”这样的问题。其实,缘由可能不只在模型,也在数据语义层。据公开报道,施耐德电气于2026年6月30日宣布签署收购协议,拟以31亿美元收购挪威工业软件公司Cognite。这笔交易值得关注的,不只是工业软件,更是数据上下文语义的价值。企业文档同样需要上下文,通用文档解析应被纳入AI基础设施清单,而不只是文件转换工具。
31亿美元买的不是一个大模型,而是什么?
施耐德所收购的软件公司Cognite,其方向是把工业数据连成有上下文的知识网。在当下大语言模型你追我赶、跑分趋于接近的时代,资本正在重新评估数据语义层的价值。大模型提供推理与生成能力,数据上下文则决定模型拿到的材料能否被正确使用。虽然收购金额不能全部归因于本体语义AI,也不能直接换算成某项技术的价格;但这一交易方向提醒企业,连接数据、保留关系、建立可信输入,是AI投资中不应忽略的一部分。
本体语义AI,究竟让数据多了什么?
要理解本体语义AI,可以先将其拆成两个词。本体,是对事物、类别、属性及其关系的形式化描述;语义,是让机器依据这套描述解释数据。在工程讨论中,本体语义AI的核心动作,是把原本隐含的数据关系显式建出来,而不是仅把文件放进同一个存储位置。
比如,某制造企业的一份合同写着设备型号,验收记录写着设备编号,技术附件写着参数范围。人可以通过业务经验判断它们是否指向同一台设备,机器却需要明确的关联依据。“文件都在”不等于“关系已知”。数据语义层要解决的,正是从孤立内容到可解释关联的距离。
不过,文档解析与完整的业务本体建设并不是一回事。文档解析首先还原文档自身的结构、阅读顺序与语义关系;而设备、合同、供应商之间的业务关联,还需要下游的实体识别、口径统一和数据治理。把这条边界讲清楚,才能避免将“解析出了段落”误认为“自动建成了企业知识网”。
企业文档为什么也会“彼此不认识”?
若把视线从设备数据移到企业办公与业务现场,另一批规模可观的沉默数据便出现了:合同、标书、年报、图纸以及各类技术附件。它们可能存在于PDF、Word、Excel、PPT或图片中。文件承载着信息,但格式、层级与版面差异,使这些内容难以直接成为模型可调用的数据。
更隐蔽的问题发生在文件内部。双栏正文有自己的阅读顺序,表格数值依赖表头解释,跨页段落应当连续理解,图注则限定了图片表达的对象。若文档解析只提取字符,忽略这些关系,即使每个字都被识别出来,组合后的含义仍可能发生偏移。
因此,“文档语义层”是将非结构化文档转化为带结构、关系与溯源信息的结构化数据,让下游系统不只获得“写了什么”,还能获得“属于哪一节”“与什么相连”“来自哪里”。这强调的是数据接入与组织能力,而不意味着文档解析可以替代业务判断。
合合信息TextIn xParse如何承接文档侧的上下文工程?
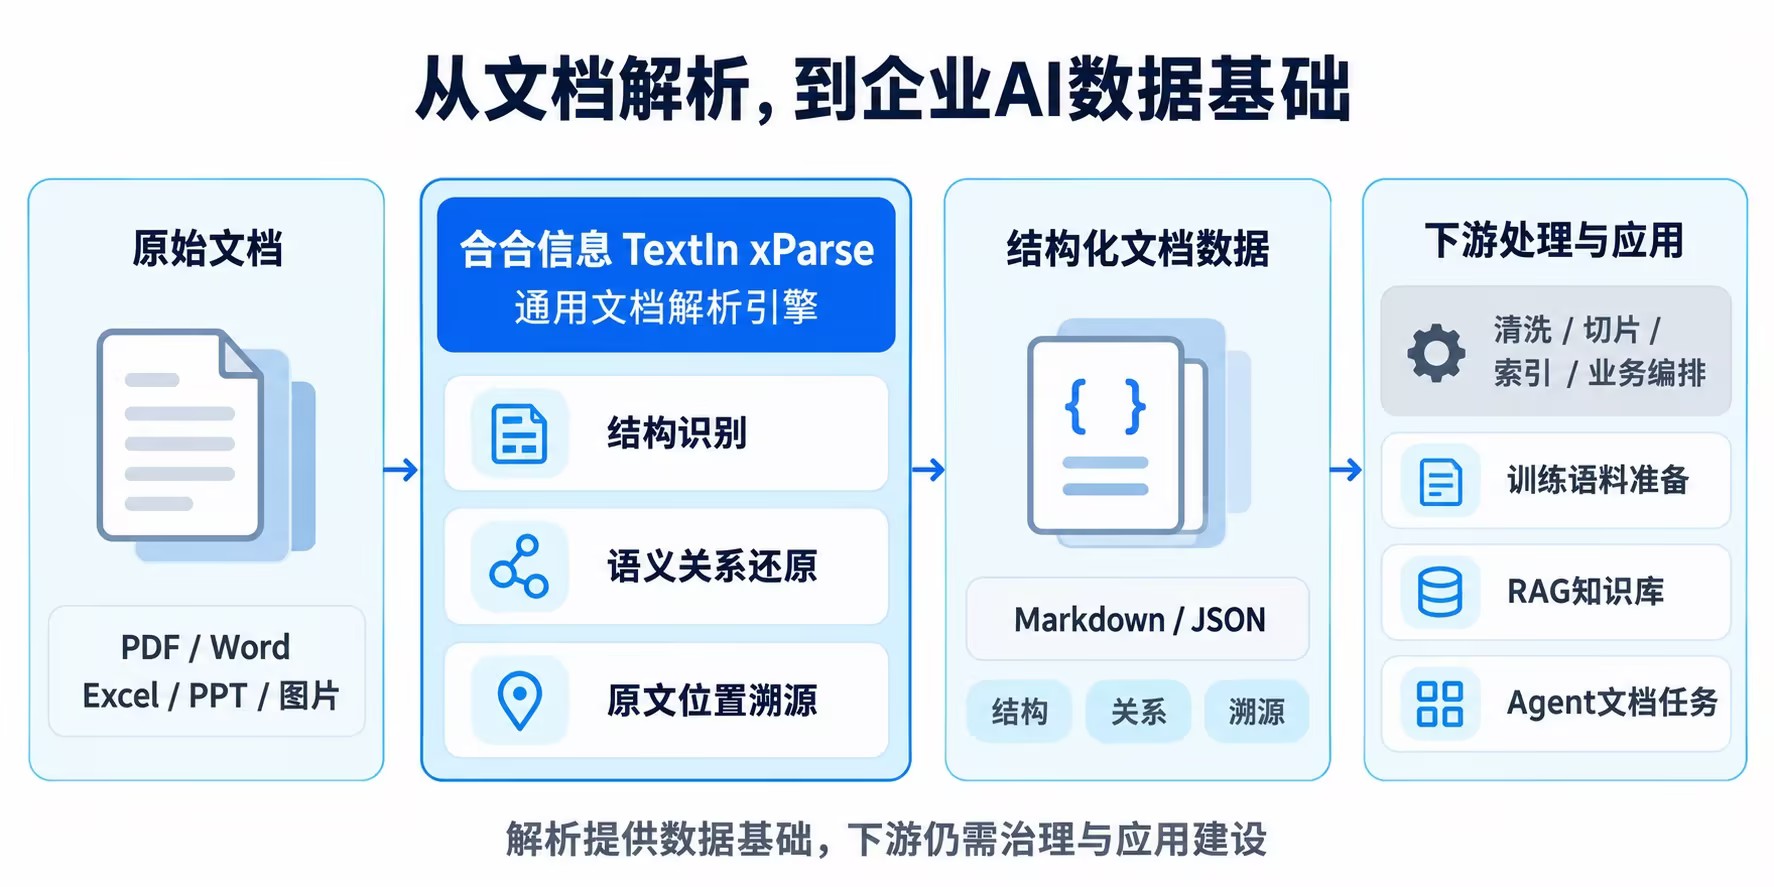
在企业AI落地的技术链路中,合合信息旗下的TextIn xParse并非简单的文件格式转换工具,而是面向大模型与Agent应用的AI Infra产品。它的核心价值不止于从文档中提取文字,更在于构建文档侧的数据语义层:将PDF、Word、Excel、PPT、图片等非结构化或半结构化文档,解析为Markdown、JSON格式的结构化数据,还原文档内部的层级逻辑与语义关联,让原本分散孤立的文档内容,转化为可被机器理解、调用与核验的高质量数据资产。若将据公开报道中Cognite聚焦的方向概括为工业设备数据的上下文工程,合合信息TextIn xParse承接的便是企业文档场景的上下文工程——核心作用正是“让数据带着关系进入AI”,为大模型训练、检索增强生成、企业知识库搭建及各类Agent应用提供稳固的文档数据底座。
先还原结构,再保留关系。在指标上,合合信息TextIn xParse可识别16种以上内容元素,包括文本、表格、图片、标题、段落、列表、公式、印章、手写体、二维码、图表、脚注、页眉、页脚、水印等。文档解析由此不再把页面视作单一文本块,而是为不同内容保留相应的结构身份。
输出结构化数据,也保留回到原文的路径。面对双栏、三栏正文及图文混排,合合信息TextIn xParse还支持阅读顺序还原;同时可输出跨页段落合并、图片与注释关联等语义关系。对下游应用而言,这些信息的价值在于连续的条款不必被页码割裂,图片也不必脱离解释它的文字单独进入检索。xParse可输出Markdown、JSON等结构化信息,并为解析结果位置信息,使文档解析结果可以定位回原文,为审核校对和答案引用提供依据,从而让核验有明确落点。
同一层文档解析,怎样支撑训练、RAG与Agent?
在大模型训练中,文档解析可提供结构化语料输入,便于后续按标题、段落与内容类型进行清洗和组织。是否进入训练,还需要企业团队自身进行处理授权、脱敏、去重与质量筛选。解析是准备工序,不是训练效果的保证。合合信息TextIn xParse的结构化输出,为这些后续处理提供了基础材料。
在RAG即检索增强生成中,文档解析影响的是“检索单元是否完整”。如果只按固定长度切片,表头与数值、条款与限定条件等结构信息可能会被拆开;如果先利用文档解析输出的标题层级、段落边界与表格结构等信息,再设计切片策略,检索就更有机会召回完整的证据单元。
在Agent应用中,结构化结果与溯源信息可以成为任务处理的输入。若某制造企业希望核对标书要求与技术附件,Agent可以在解析结果上查找相关条款,并返回对应页码供人员复核。
采购文档解析,应当关注的各项指标
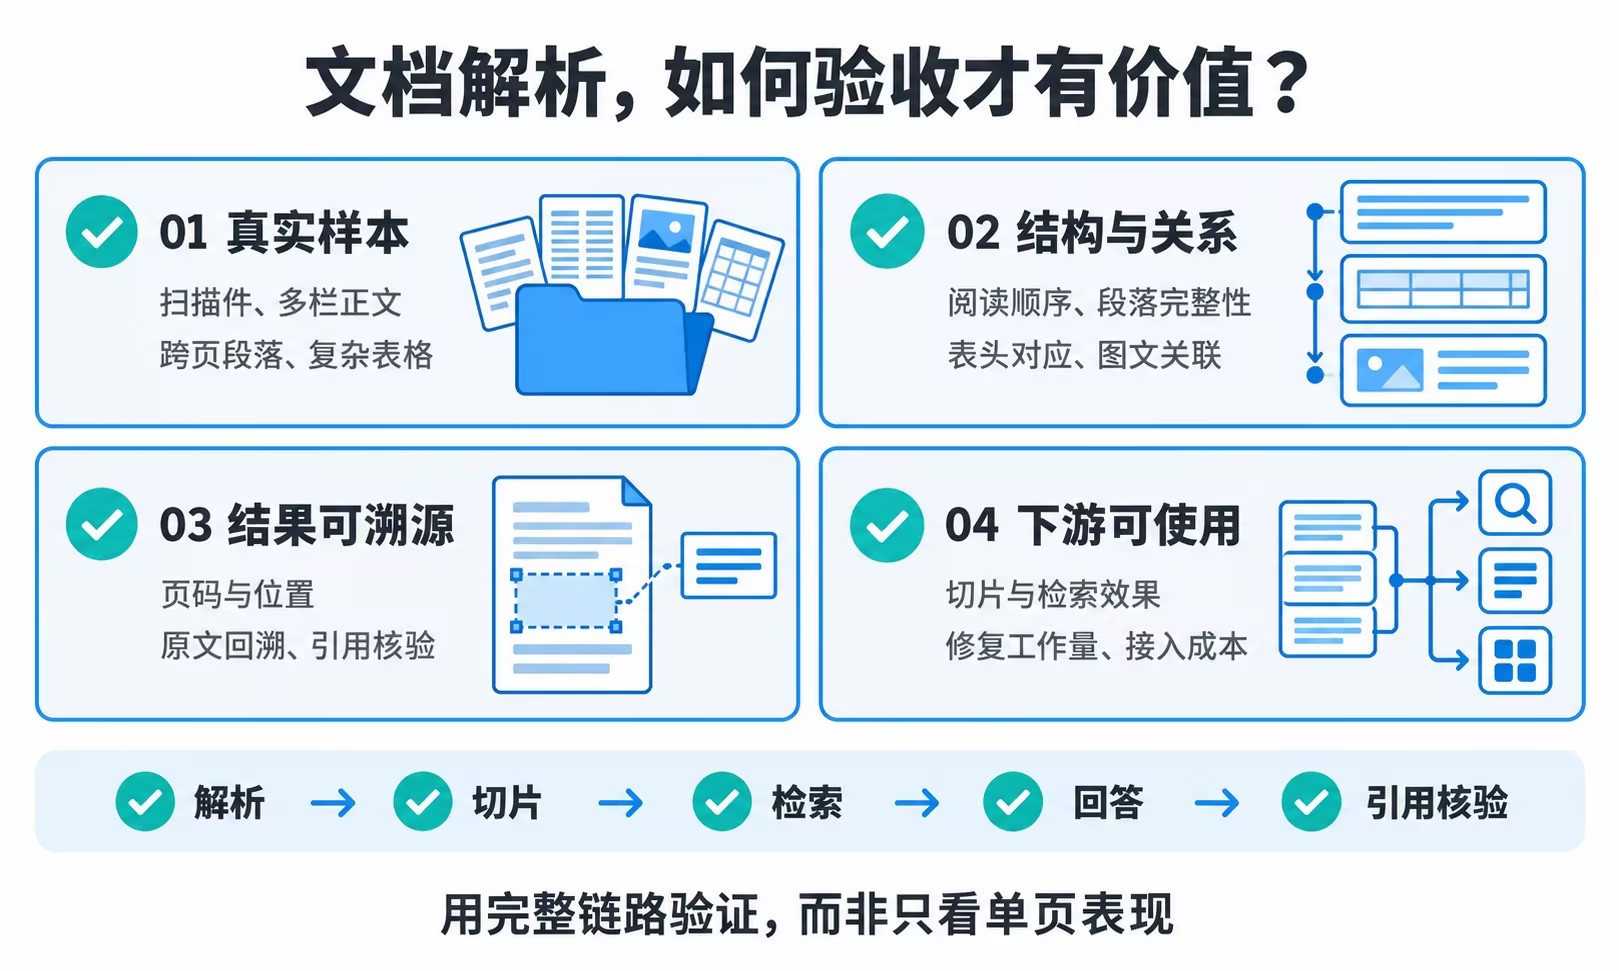
企业采购数据语义层相关能力时,值得把评价对象从“识别了多少字”扩展为“留下了多少可用上下文”。建议先准备覆盖扫描件、多栏正文、跨页段落、图注及复杂表格的代表性样本,再检查阅读顺序、语义完整性、结果溯源与下游接入成本。不要仅凭一份排版规整的文档判断实际适用性。
产品的具体性能也应放到业务条件中理解。合合信息TextIn xParse对100页长文档的解析快至1.5秒,离线批量处理可在3天处理500万页PDF,其对复杂文档的综合还原度可达95%。对企业来说,有价值的验收方式,是企业团队用自己的样本串联“解析—切片—检索—回答—引用核验”完整流程,观察错误出现在哪个环节,再判断文档解析投入是否减少了后续修复与人工核对成本。
地基比模型值钱,应该怎样理解?
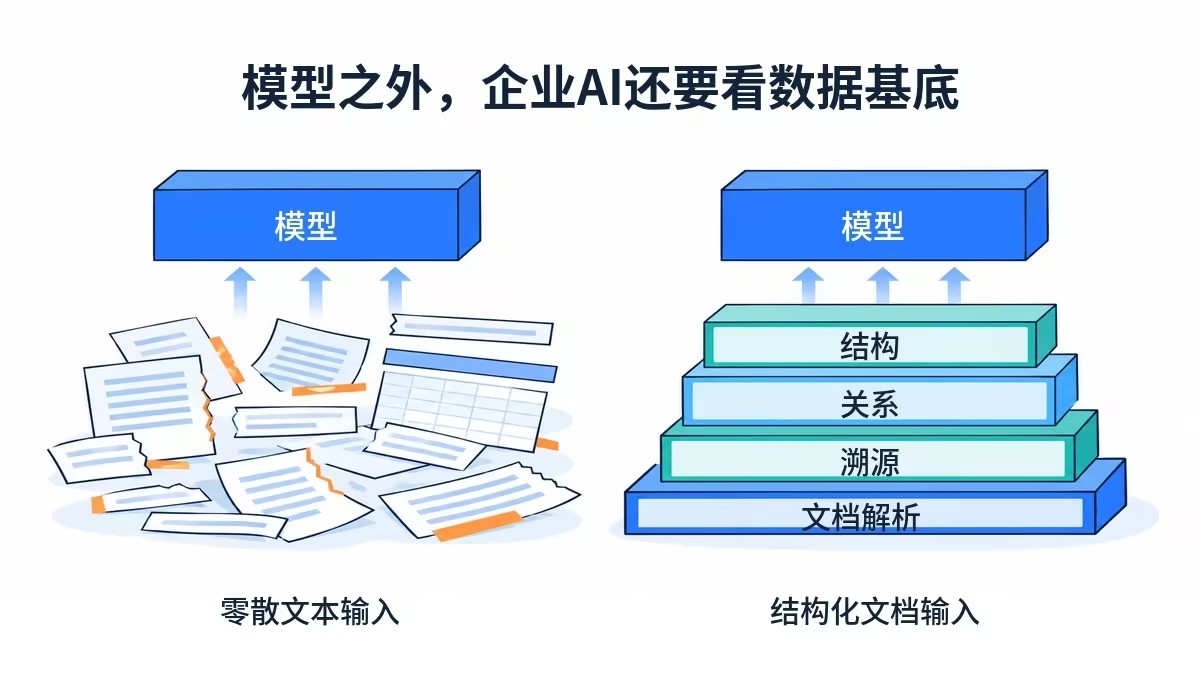
对企业来说,在大模型时代,“地基比模型值钱”值得作为投入优先级的提醒。当企业的瓶颈是证据不完整、关系被拆散、答案无法溯源时,继续升级模型未必是最有效的第一步。先修复输入,再评价模型,或许能更清楚地区分数据问题与推理问题。
本体语义AI提示我们关注显式关系,数据语义层提示我们关注可解释的数据组织,通用文档解析则提供了企业文档场景中一个具体的起点。建议企业把文档解析纳入AI基础设施清单,并将结构完整性、语义关系与可溯源性写入验收标准。对于准备建设大模型与Agent应用的团队,不妨从合合信息TextIn xParse入手,先验证地基,再扩展应用。