档案专题数据库建设新规落地:档案内容提取怎么做,100% 质检怎么过?
10 月 12 日,国家档案局发布 DA/T 109—2026《档案专题数据库建设工作规范》官方解读。该标准已于 2026 年 9 月 1 日起实施,是我国首部专门规范档案专题数据库建设的行业标准,适用于各级国家档案馆、机关及企事业单位档案室。对已经完成档案数字化的单位而言,这份解读的核心指向很明确,即扫描件和 PDF 里的内容还不能被直接调用,专题库建设需要把正文里的信息进一步提取出来,变成可核对的档案数据结构化成果。
谁要建、谁来建
前述标准的适用范围是各级档案部门,包括国家综合档案馆、专门档案馆、部门档案馆以及机关和企事业单位档案室。也就是说,四级国家档案馆体系加上各类机关企事业单位的档案室,都在这套规范的覆盖范围内,其档案数字化成果均面临进一步的数据结构化要求。
谁来承建?解读在"实施模式"部分给出了三条路径:独立实施、跨区域跨层级跨部门合作实施,以及服务外包。对于多数尚未配备完整技术团队的档案馆而言,服务外包是常见选择。这意味着,档案数字化服务商和系统集成商将成为专题库建设的主要承建方,而标准对档案内容提取、整理著录、质量管理提出的具体要求,将直接转化为服务商的能力清单和验收口径,档案数据结构化能力成为核心竞争力。
三种建设方式,内容提取为什么被单列
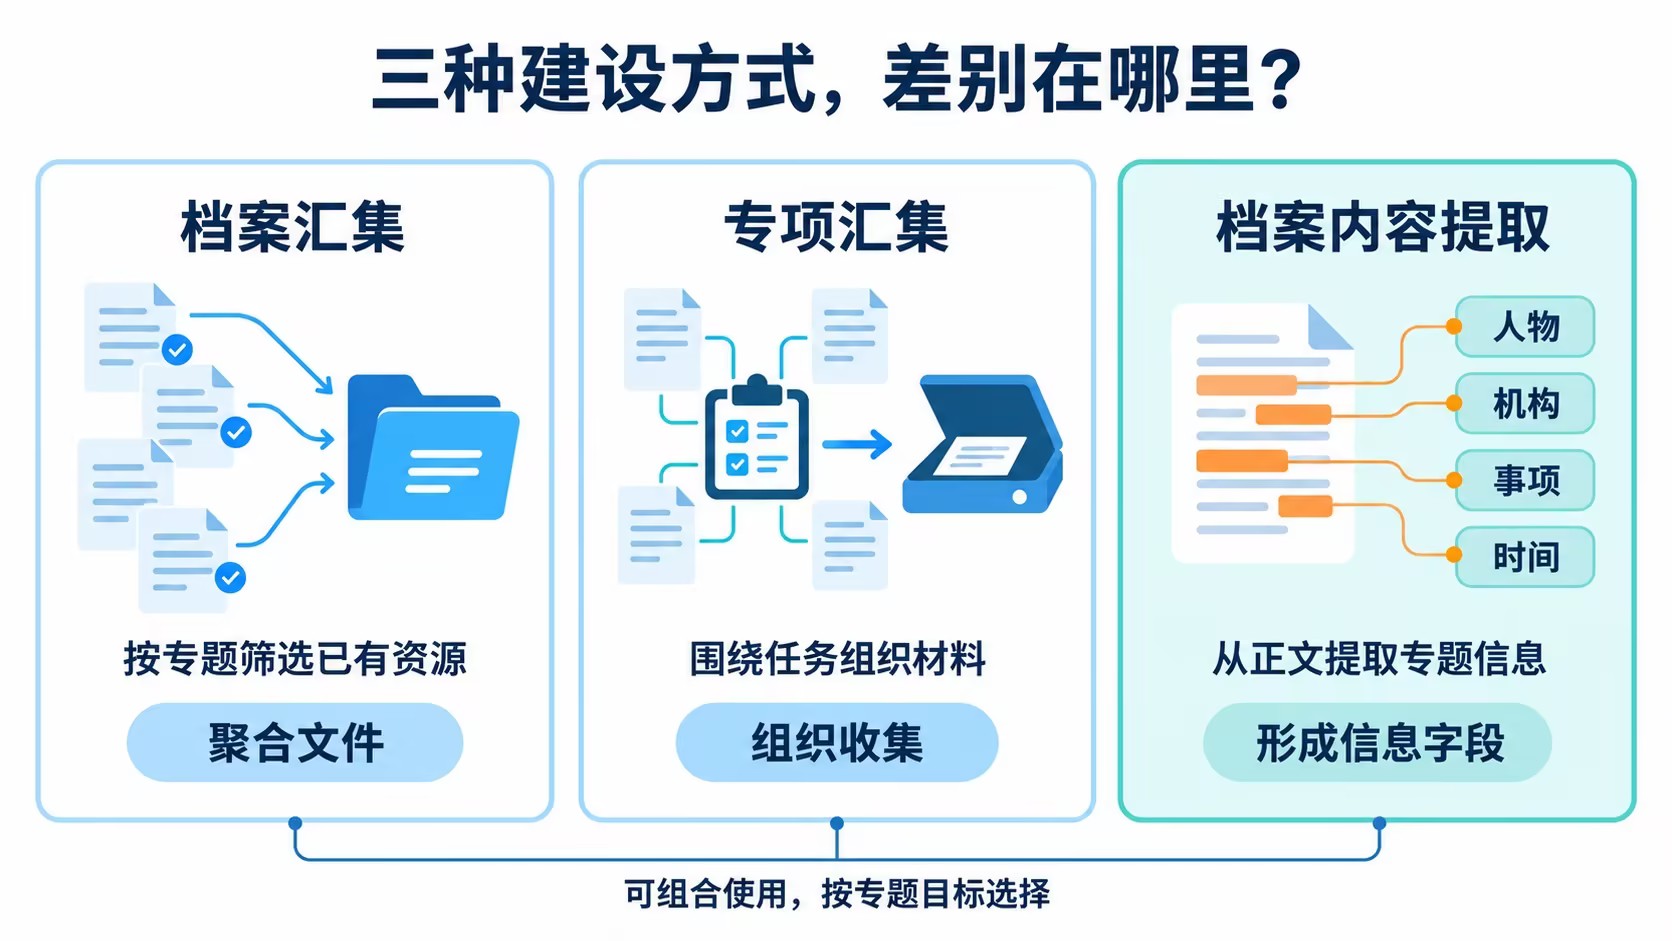
标准把建设方式分为三类。档案汇集是对现有馆藏数字资源按专题筛选聚合,是最直接的方式,但专题库的内容范围由馆藏自身决定;专项汇集围绕特定工作或重大活动,重新组织文件材料的收集与数字化;档案内容提取则不同,它要求对馆藏档案的正文内容进行分析,从中提取与主题相关的信息,再形成专题数据库。
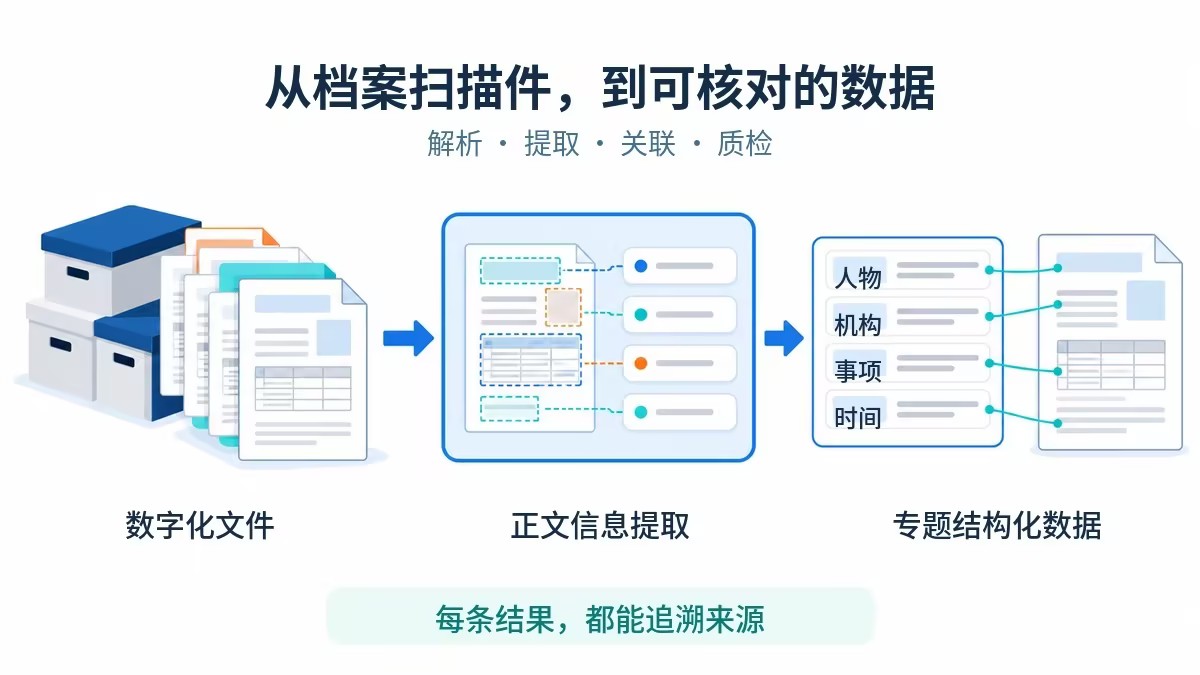
差别在于,前两种方式改变的是文件的"组织方式"——档案数字化成果以什么形态进来,大致就以什么形态入库;档案内容提取改变的是"数据本身",它会生成案卷目录里原本不存在的字段与条目,比如人物、机构、事项、时间线。对已经完成档案数字化的单位来说,这一层如果不补上,专题库就只能从已有目录里挑文件,而无法从正文中获取新的信息维度,档案数据结构化也就无从谈起。
解读同时提到,实际工作中往往组合使用三种方式。这也说明,档案内容提取不是替代其他方式,而是在汇集的基础上,对正文内容做一次深度提取。
100% 质检:覆盖面定了,参照物从哪来
解读对质量管理的表述是:为保证数据质量,应按照数据汇集业务规范的要求,对数据进行 100% 质检,根据需要进行数据清洗。这里需要先厘清口径——100% 说的是检查的覆盖面,不是要求识别准确率达到 100%;检查可采用人工或技术辅助的方法完成;数据清洗的对象是不准确、不完整或不一致的信息。
覆盖面定在 100%,意味着每一条被提取的数据都要有一次比对动作。比对的参照物只能是它来源的那一页原文。也就是说,档案内容提取产出的字段,在生成时就要带上"来自哪一页"的信息;事后再去翻文件补,等于按条目数补一遍。标准 9.2.1 条对此有明确要求:从档案内容中分析提取的数据应进行结构化整理,保证电子目录与档案原文关联正确。"关联正确"四个字,在档案数据结构化的质检环节就是硬约束。
技术落点:原文关联怎么做
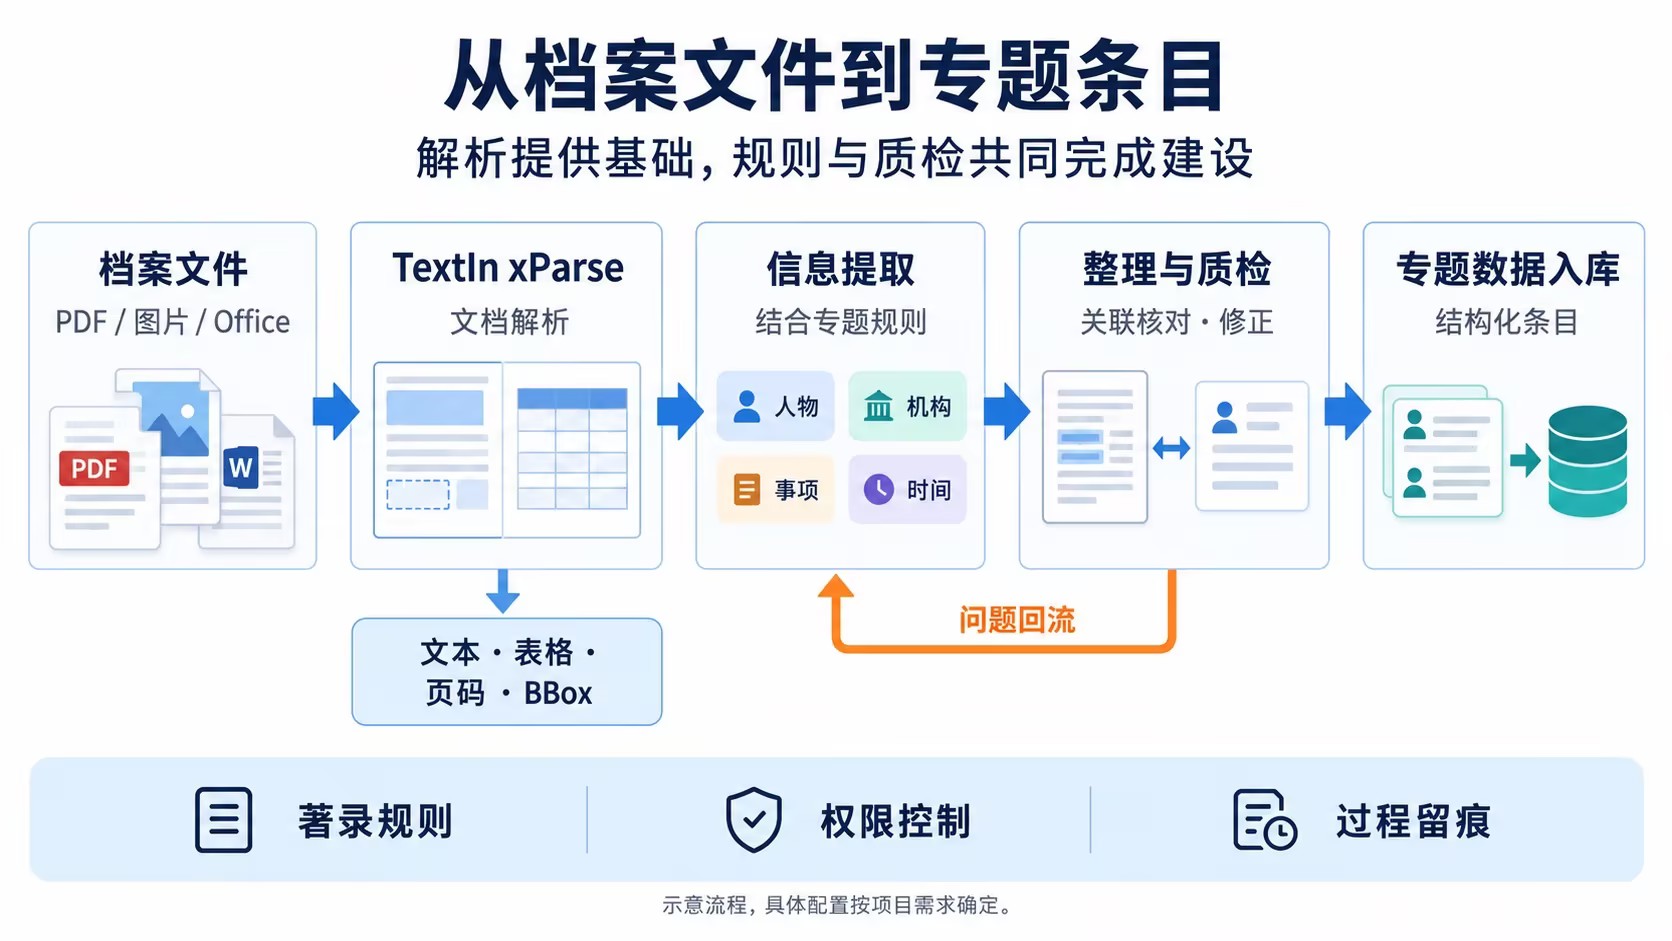
把正文内容抽出来,并让每条结果能够指回它在原文中的位置,这两件事可以在同一次解析里完成。合合信息通用文档解析TextIn xParse 是通用文档解析引擎,输入覆盖档案数字化形成的 PDF(含扫描件)、Word、Excel、PPT、图片与 CAD 图纸等常见格式,以 API/SDK 方式调用。
对应"原文关联"这一要求,xParse 的解析结果除字段内容本身,还保留三组位置信息:所在页码、内容块在页面上的坐标范围(BBox)、以及所属层级结构。表格按层级输出,跨页关系与合并关系留在结构里,单元格位置一并保留。结果支持 Markdown、JSON 等输出格式,其中 JSON 保留上述全部位置信息,供系统直接读取。这意味着,档案内容提取产出的每条字段都能对应回扫描件上的具体位置——目录项与抽取结果不一致时,先按页码定位再判断;哪一行缺了、缺在哪一格,也可以直接比对,不必整件翻找。这也是档案数据结构化在输出侧要完成的核心动作。
以某市级档案馆的专题库建设为例
其档案数字化已覆盖历年馆藏,案卷目录里有题名、责任者、时间等字段;而专题库需要的是人物、机构、事项与时间线,这些信息只存在于正文里,且分散在不同案卷、不同年份的材料中。对此,该馆可以接入合合信息文档解析TextIn xParse,批量提交档案数字化形成的 PDF,系统便可以将正文按阅读顺序组织,表格按行列层级还原,印章与手写批注单独归类,输出带页码与 BBox 坐标的 JSON。抽取出的要素据此聚合为专题条目,每条都能对应回具体案卷与页码,再与目录项逐条比对。如此,预期效果是后续核对可以从逐件翻查变为按坐标定位,问题件可直接落到具体页码,入库前核对周期有望缩短;专题条目也不再受限于案卷目录已有的字段。需要说明的是,档案内容提取的完整流程还包含著录规则制定与质量检查,解析环节提供的是可核对、可定位的数据基础,也是档案数据结构化不可或缺的一环。
批量推进时,除了精度还要看什么
当档案内容提取进入批量阶段后,精度是基础,更影响整库推进的是吞吐与稳定性。xParse 对常规印刷文字识别率 99.77%,表格识别率超过 99%,对于100 页长文档 PDF 的在线解析快至 1.5 秒,离线批量解析可在 3 天内完成 500 万页 PDF,日均支撑数百万级调用量,成功率 99.999%。
在部署形态上,云端 API、SDK、私有化部署(本地服务器或私有云)、端侧 SDK 与云原生部署均可选择。档案数据通常要求不出域,私有化部署是常见选择,配合完整日志与错误追踪、图像篡改检测、印章与手写签名检测,可满足过程留痕要求。费用一般按调用量或私有化部署方案评估,具体以商务方案为准。可先以云端 API 跑一批混合样本,确认输出符合自身著录要求,再决定是否转为私有化部署。
自己的档案能不能被正确解析,怎么验证
档案数字化存量里,同一批材料往往混着印刷体、手写批注、跨页表和盖章件,能不能准确解析看参数判断不了,只有用自己的件跑一遍才作数。建议有需要的团队可以取 200 件左右、类型混合的样本先做一轮验证,检查三件事:阅读顺序是否正确、跨页表是否还原、抽取结果能否按页码与坐标回指原文。三项过关,再谈批量规模与部署形态,档案内容提取与档案数据结构化的推进路径会更清楚。
档案数字化积累了大量值得被调用的内容,而调用的前提是这些内容先经过档案数据结构化,变成可定位、可核对的数据。档案内容提取正是实现这一转化的关键步骤。点击下方图片,了解更多合合信息通用文档解析产品的内容信息。