招投标AI解析政策密集落地,标书结构化能力成准入门槛
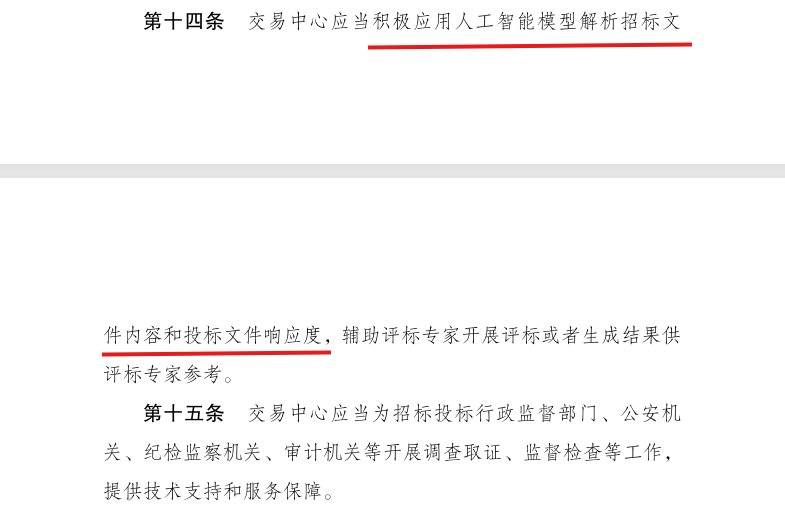
2026年7月,《公共资源交易中心招标投标现场管理暂行办法》(国家发展改革委等 7 部门令 2026 年第 43 号)发布,其中第十四条明确:交易中心应当积极应用人工智能模型解析招标文件内容和投标文件响应度,政策将于2027 年 1 月 1 日起施行。然而,在当前的招投标全流程里,实际情况往往是上百页的投标文件要靠人工逐页翻找,扫描件里的印章也要单独辨认,若遇到各种复杂表格等,还会遇到解析识别错误等问题。
所以,文档解析是打造招投标数智化新范式的第一步。如果文件解析不准,则后续的检测、比对与评审都建立在错误数据上;而若文件读得慢,则又影响招投标项目的推进。
政策解读:人工智能要融入招投标全流程的每个环节
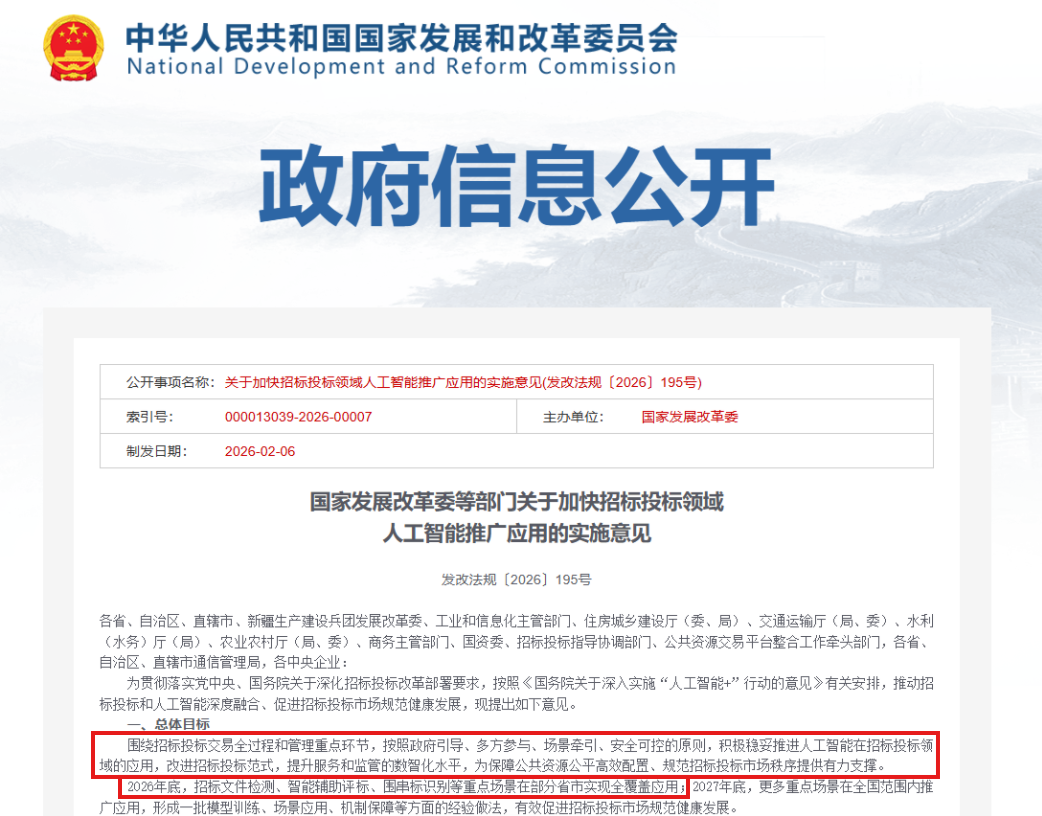
《国家发展改革委等部门关于加快招标投标领域人工智能推广应用的实施意见》(发改法规〔2026〕195 号),围绕“人工智能+招标、投标、开标和评标、定标、现场管理、监管 6 个方面提出 20 个重点场景。其中,招标环节提出“招标文件检测”,要求自动识别排斥竞争条款、违法违规表述及错敏词;投标环节提出“投标合规自查”,要求对照招标文件进行响应性比对;开评标环节提出“智能辅助评标”,要求提取关键要素、辅助打分;现场管理环节提出“档案管理”,要求实现智能命名、摘要检索。前文所提43 号令第二十三条还要求,招标投标现场记录卷宗自形成之日起至少保存 15 年。把这些场景排在一起看,会发现一个共同的前置条件:无论检测、自查、评审、核验还是归档,第一步都是需要将招投标文件的内容信息结构化处理。所以文档解析不过关,后面的流程都成了空谈。
为什么招投标材料文件难解析:因为类型实在太复杂了
其实,招投标判断规则的内容并不是很复杂。比如,资格条件有没有达到、历史案例数量够不够、评分项是否响应,这些标准在招标文件里写得很清楚明白,流程中的难点是按这样的检查要求去上百页的材料里找答案。而这些答案又存在于上百页的材料文档的角落里。
往往,一个招投标项目就涉及招标公告、资格预审文件、招标文件、投标文件、澄清文件、评标报告、合同等多类材料,内容类型不同、文件格式也不同,人工处理费时费力,难免还有错漏。
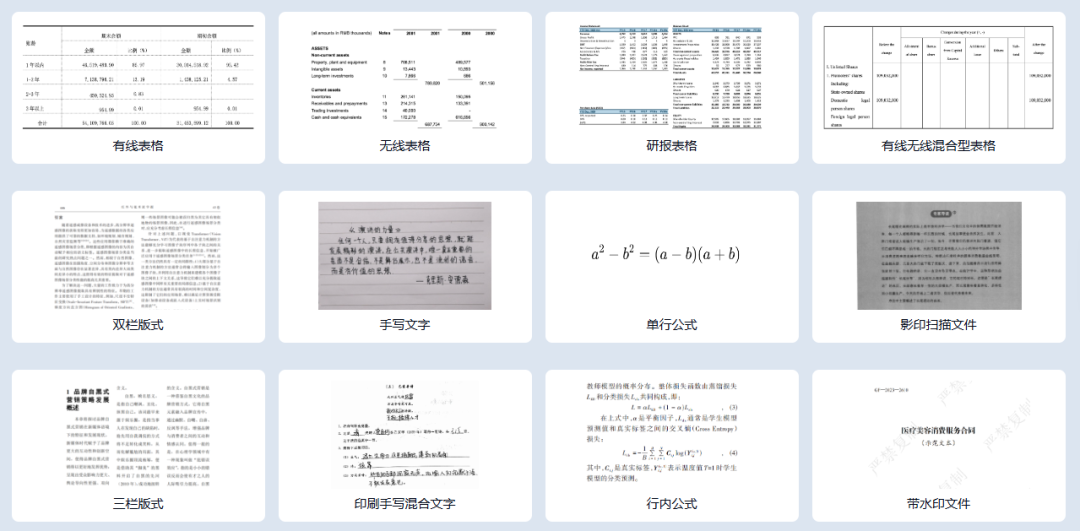
此外,版式的复杂和差异化也是相关文档做解析的难题。比如,技术需求清单可能是一张跨页长表,表头在上一页、具体内容则续到下一页,中间还夹着不同的合并单元格;一些证照文件又是典型的有线、无线、少线混合表;而印章、签字页则多为扫描件,需要单独识别。如果这些都还原不准,标书解析出来的字段就会错行、错列,相关数据信息也就无法使用了。
而若使用传统OCR处理这类招投标材料,则诸如跨页表和合并单元格的错行问题就很容易出现,从而影响相关工作推进。
政策当前,又该如何又准又快的做好标书文件解析?
合合信息TextIn xParse 是一款通用文档解析引擎,支持将 PDF、Word、Excel、PPT、图片、扫描件等非结构化文档解析成结构化数据,并按 Markdown 或 JSON 格式输出,从而赋能大语言模型、智能体、RAG等下游任务。针对招投标文档处理场景,可提供以下价值:
1、多份材料之间的交叉核验
实际业务中,招投标的判断很少只看一份文件。43 号令第二十九条第(三)项要求,交易中心发现投标人“提供资质、资格、业绩、奖项、信用等信息与有关主管部门公布的信息不一致”的,应当通过电子交易系统向评标委员会作出提示。由于各种材料通常为不同格式的文件,人工翻阅对照麻烦,此时便可使用xParse通用文档解析引擎,从多份文件中结构化提取对比维度的关键字段,进而支撑多份文档之间的字段交叉核验。
2、解析结果可查证,支持溯源定位
招投标场景对结果准确性的要求往往比对效率更硬一层。xParse 支持对解析结果的溯源定位,帮助业务人员快速确认信息来源,同时还能直接与内嵌的大模型进行问答,针对特定内容做交互理解。对于需要留痕、需要解释“为什么这样判定”的评审与监管环节,这一点比单纯的准确率更关键。
3、满足各种材料文件的结构化解析
招投标材料文件往往是不同格式的文档,而xParse 支持 PDF、Word、Excel、PPT、图片、HTML 等多种格式文档,可识别正文、标题、表格、图片、公式、页眉页脚、印章、手写体等 16 类以上内容元素,同时支持双栏、三栏文本段落与图文混排,也可处理加密 PDF 和扫描件。
如要批量处理多份投标材料,xParse 还支持高并发处理,离线状态下能做到3 天解析 500 万页 PDF。解析结果可无缝衔接大模型,用于知识库、检索与智能问答等下游任务。
准确率、部署方式与计费模式
指标上,合合信息的xParse 的印刷文字识别率达到 99.77%,表格准确率 99%,复杂文档综合还原度85%- 95%。稳定性上,它能够日均支撑数百万级调用量,成功率 99.999%,还支持 52 种以上语言文字的识别。
部署方式覆盖云端 API、SDK,并能够进行私有化部署(本地服务器或私有云)。基于招投标场景,推荐选择私有化部署,确保数据安全性。计费上提供按量计费与私有化买断等方式,具体以商务方案为准。
一个招投标全流程的文档解析场景
以某地交易中心的电子招投标场景为例。该场景下的单个项目通常涉及招标公告、招标文件、数份数百页的投标文件、澄清文件、评标报告与中标合同等,材料总量大、版本多变。
通过接入合合信息的TextIn xParse,各类材料上传后自动完成标书解析与结构化处理,招标文件的资格条件与评标办法、投标文件的资质业绩与报价,这些都可以被整理成可对照的数据;澄清文件更新后,相关条款也能在解析后快速迭代。企业团队通过使用xParse,从招标文件检测到评标要素提取、再到档案归集,各环节的人工翻阅与重复录入都有望明显减少,条款漏检与版本误用风险同步下降,从而达到政策中提到的:从“人防”向“技防”的转变。
点击下方图片,了解更多合合信息TextIn xParse 在招投标场景的产品信息。