科研文献解析成为“数据基建”:50亿美元押注AI制药IsoDDE
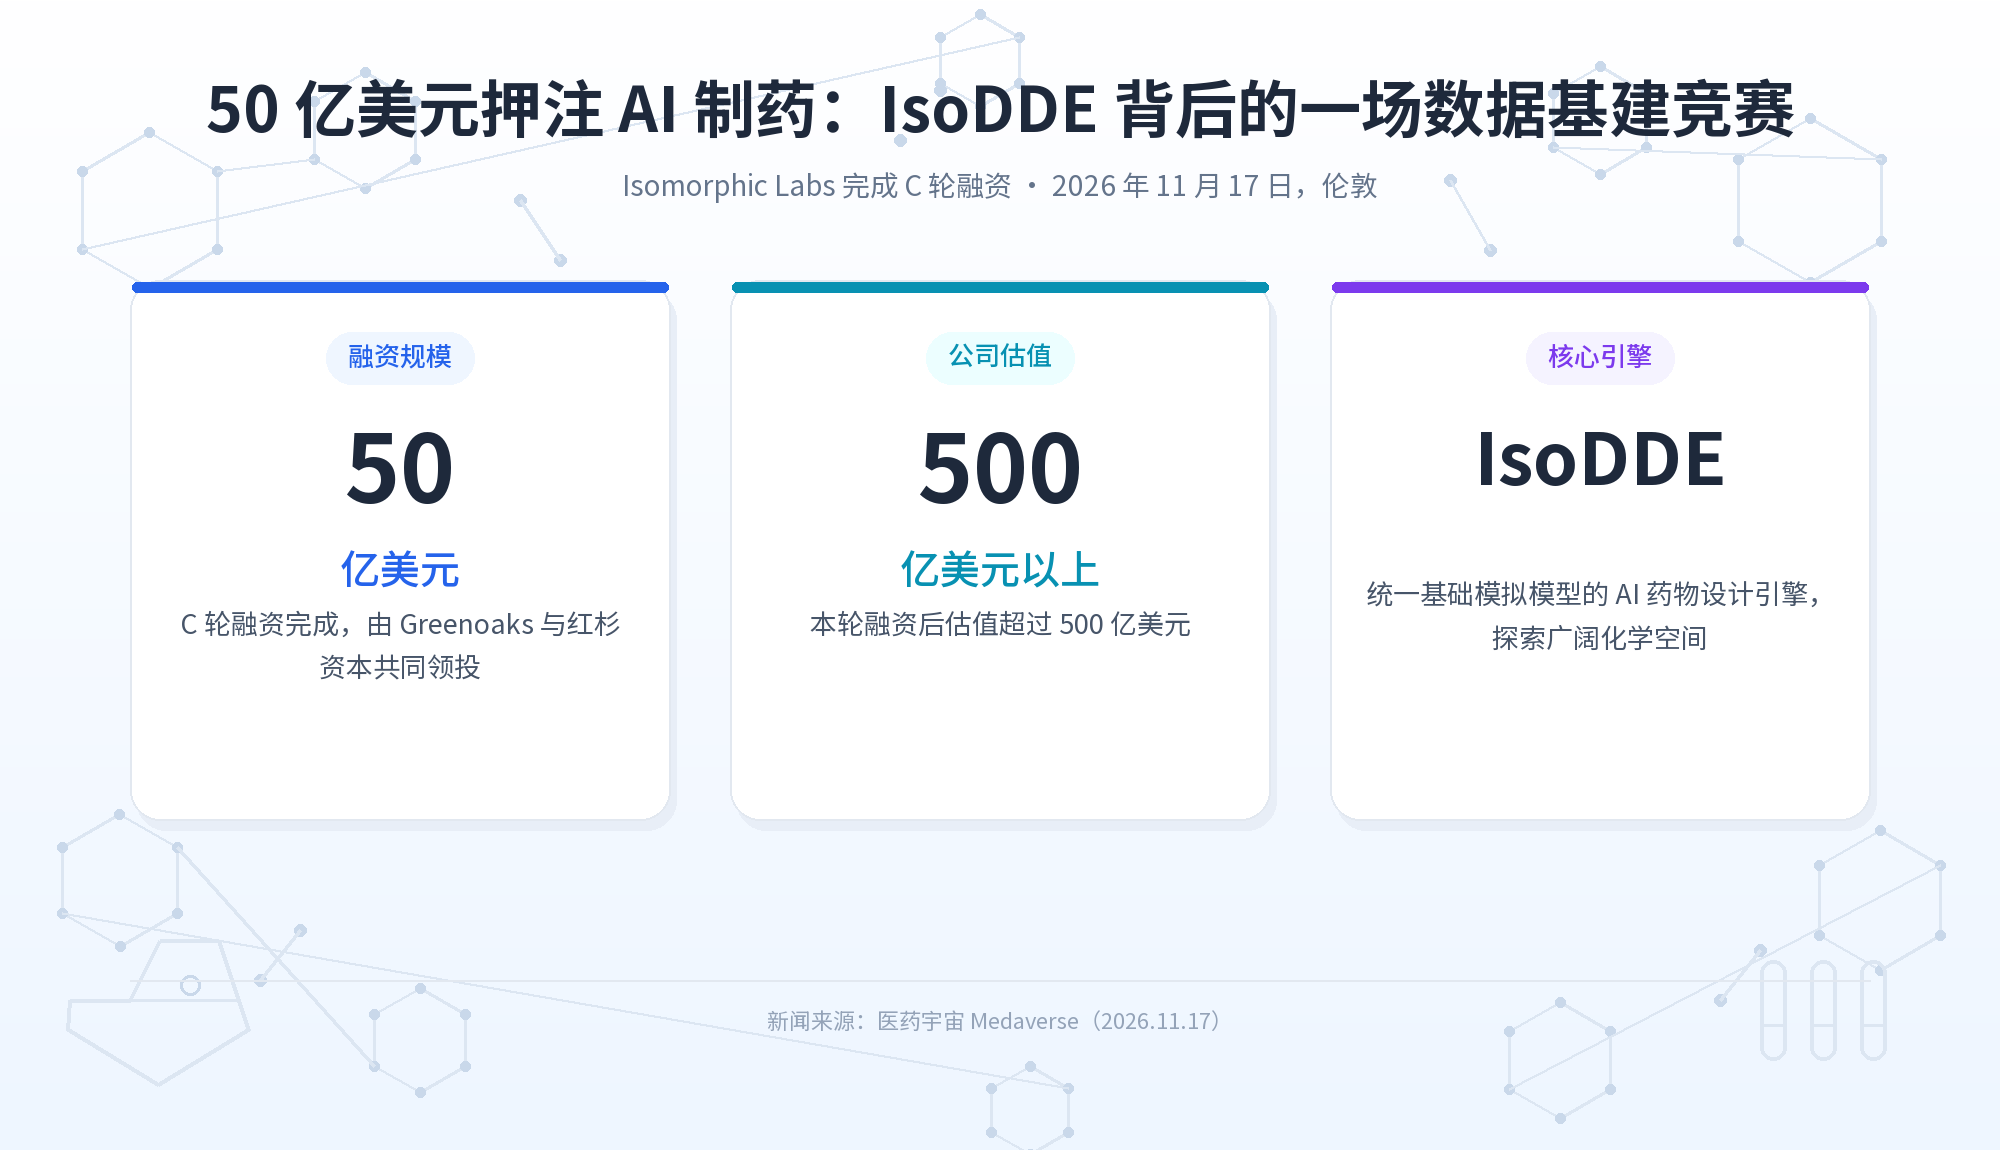
2026 年11月17日,伦敦AI药物设计公司Isomorphic Labs宣布完成50亿美元C轮融资,由Greenoaks与红杉资本共同领投,Andreessen Horowitz等新投资者参投。这家公司在公告里透露出一个信息:药物发现正在变成一项可以用人工智能系统持续优化的工程。他们自研药物设计引擎IsoDDE统一了多类基础模拟模型,尝试在广阔化学空间中设计、改进并交付候选分子。Greenoaks创始人Neil Mehta把发现和开发新药概括为"几乎无限规模的优化挑战"。对国内的生物医药研发团队、CRO机构与AI制药创业公司而言,这条新闻释放的信号很直接:AI制药的竞争重心,正在从"模型能不能跑起来"转向"喂给模型的科研文献解析是不是足够干净、足够结构化"。大量论文、专利、临床报告以双栏PDF、复杂表格、公式和扫描件的形态存在,模型就算再强,也要先把这些文献读懂。
论文读不懂,问题往往出在"版面"而不是"内容"
普通文字识别工具在读一篇典型的多中心临床研究报告时,最容易出问题的不是文字本身,而是在如何弄清楚它的结构。双栏排版的正文如果按视觉顺序逐行拼接,那么参考文献和正文就会混在一起;跨页续表被拆成两段,这就会导致表头在第二页消失;合并单元格里的数值如果错位一行,那么整个剂量组的含义就变了;公式与上下标容易转成普通字符,导致后面做信息抽取时根本对不上号。更复杂的是扫描件的水印、折痕、倾斜、印章压字这些问题都会转化成噪声进入识别流程。
这些问题在单篇文档里仅仅只是"看着别扭",但是一旦汇入RAG知识库,就会被放大成系统性问题。切块后的片段如果缺少上下文,那么检索召回的就会是半截表格或者残缺的数据。当不同文献里同一靶点的表述对不齐,如果追问一句"某适应症的最新证据是什么",那么给到的答案里可能混着旧版本结论甚至是出错的结论。科研文献解析如果只做到"把字认出来",那么就远远不能满足AI制药需要可用上下文的要求。
别让模型直接啃PDF:先把文献变成可计算的数据
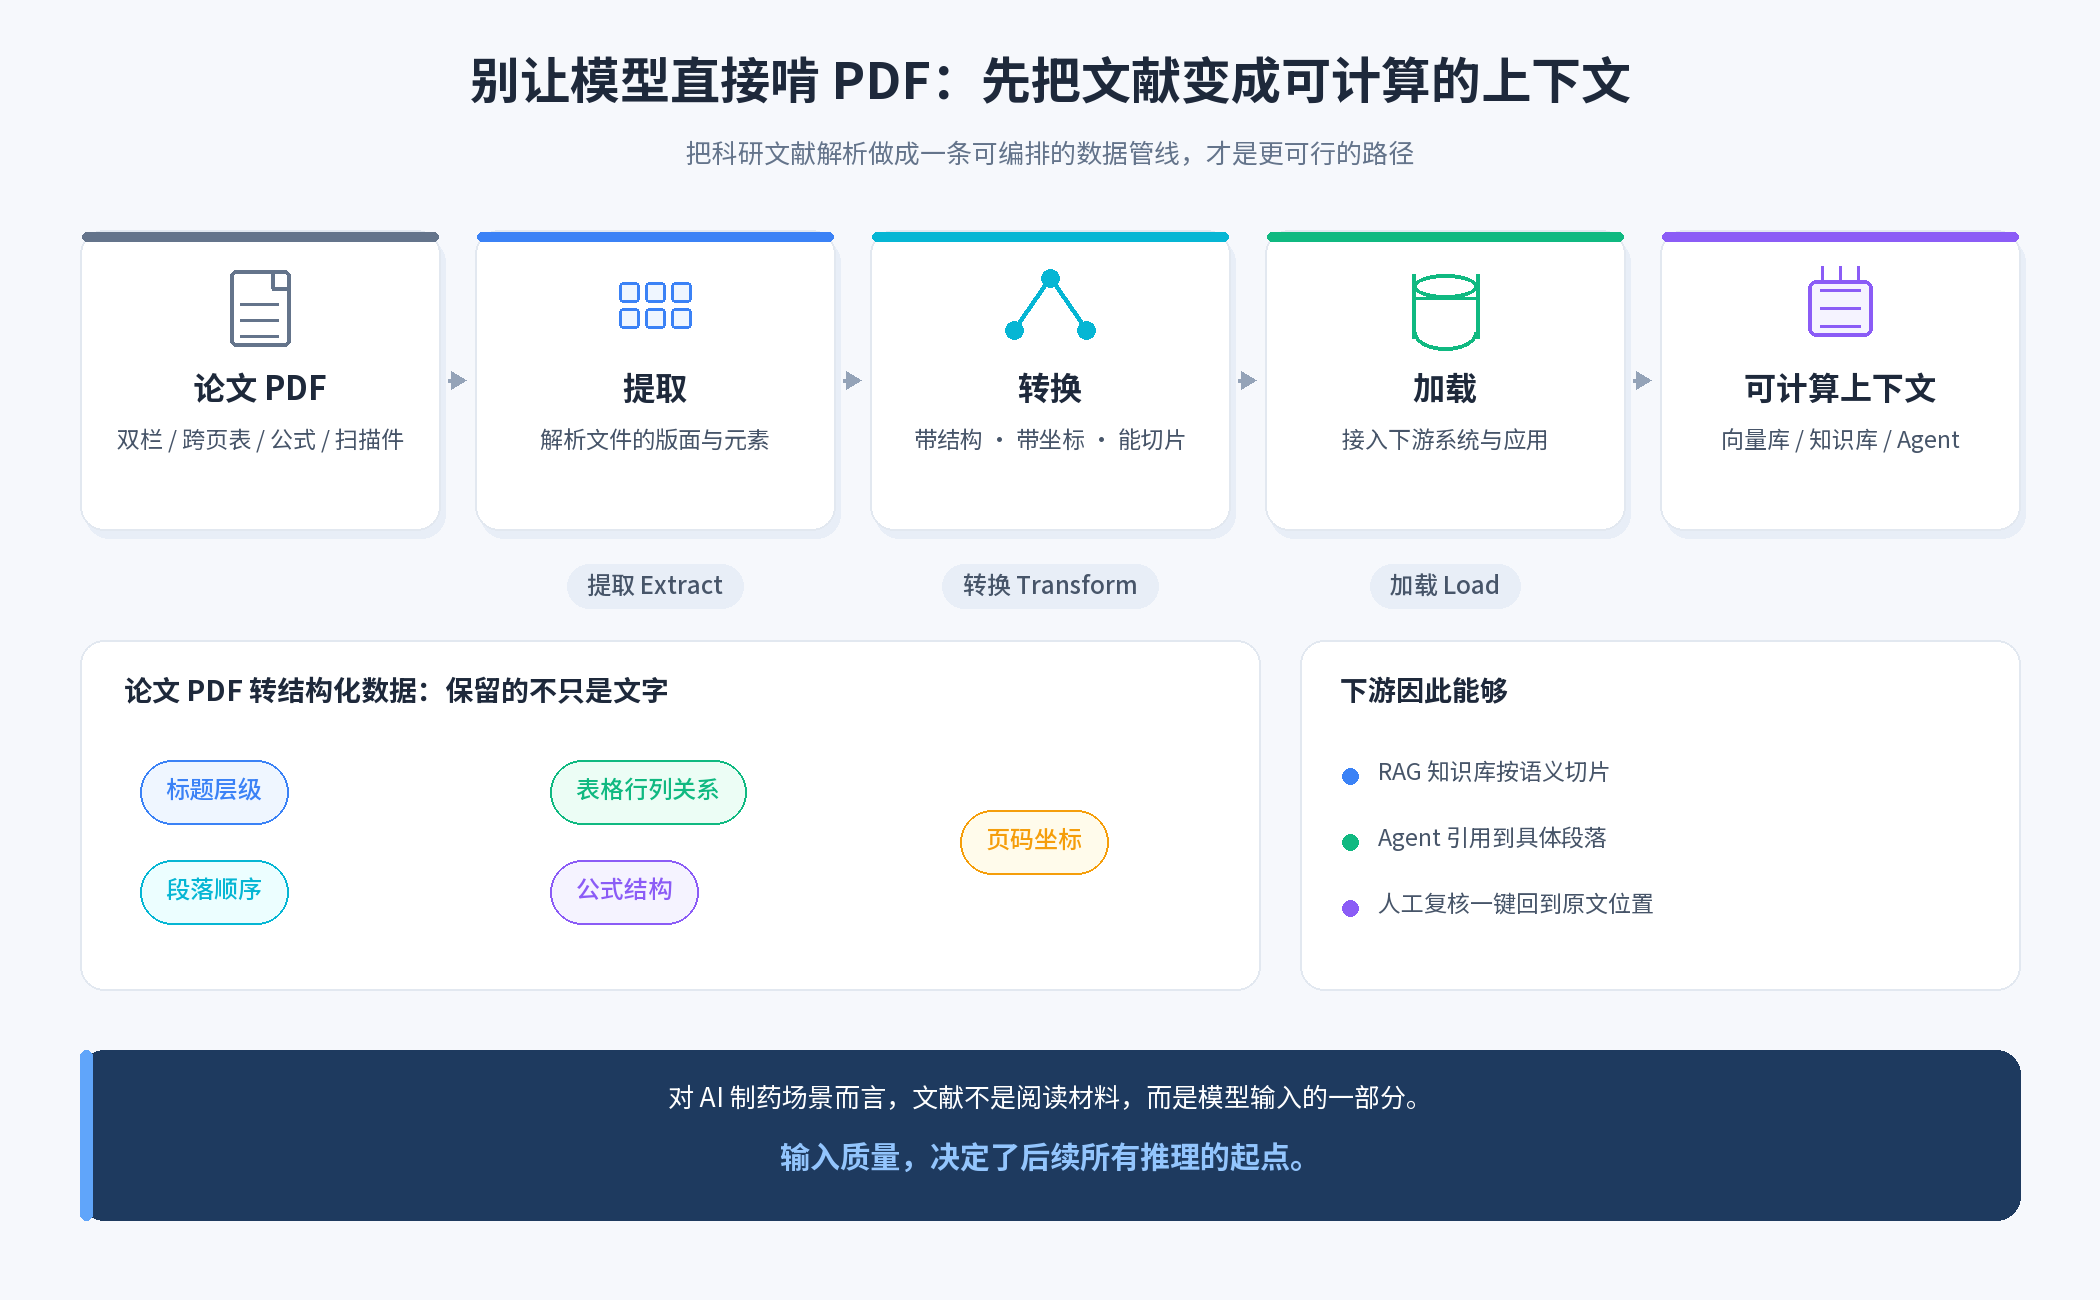
把科研文献解析做成一条可编排的数据管线才是更可行的路径。首先解析文件的版面与元素,再把内容转换成带结构、带坐标、能切片的数据,最后加载进向量库、知识库或Agent。这条链路的价值在于,把"读懂文献"这件模糊的事,拆成可以逐项验证的工程动作——提取、转换、加载。
具体到论文PDF转结构化数据这个过程:关键在于不是输出一段纯文本,而是保留标题层级、段落顺序、表格行列关系、公式结构和页码坐标。这样下游的RAG知识库才能按语义切片,Agent据此引用到具体段落,人工复核时也能一键回到原文位置。对AI制药场景而言,文献不是阅读材料,而是模型输入的部分原料,输入质量决定了后续所有推理的准确性。
合合信息 TextIn xParse:把解析这一层做厚
合合信息TextIn xParse(以下简称xParse)是合合信息旗下的一款通用文档解析引擎,官方定位为AI基础设施产品。为了满足企业非结构化文档挖掘的需要,它可以把复杂文档解析成结构化数据,向上对接大模型训练、RAG知识库与Agent应用。它支持的输入格式覆盖PDF(含加密与扫描件)、Word、Excel、PPT、图片、HTML、邮件与CAD图纸等,输出则包括Markdown、JSON、HTML与Excel等格式,便于直接进入下游系统。
在元素层面,这款引擎可识别文本、表格、图片、公式、手写体、图表、脚注等16+种元素,版面识别方面支持双栏、三栏与图文混排,表格支持有线表、无线表、合并单元格、嵌套表头与跨页长表,并针对学术论文和技术文档中的公式做了专项解析。专项优化医疗和科研文献场景,更加适配各类医疗文献、事故报告与案例,适配多源多模态文档,用于提升知识库问答品质。换句话说,科研文献解析不是它的顺带能力,而是被单独打磨过的使用场景。
性能上,xParse对100页长文档PDF的在线解析快至1.5秒,离线批量模式下3天可精准解析500万页PDF。对于常规印刷文字,识别率可达 99.77%,表格识别率达到99%,复杂文档综合还原度约95%;同时覆盖52+种语言识别,日均支撑数百万级调用,成功率达99.999%。
比参数更值得技术决策者关注的,是生态与部署。它提供云端API与Python、Java、Go、Node.js等SDK,支持私有化部署以适配数据不出域的要求。同时提供LangChain插件,并可对接Coze、Dify、MCP Server、FastGPT、RAGFlow等平台。这意味着论文PDF转结构化数据之后,可以顺着既有技术栈流入RAG知识库,而不必为解析单独造一套轮子。此外,解析与问答结果支持溯源,在追问"这个结论来自哪篇文献的哪一页"时,系统能给出位置依据。
实际应用假设:建设文献知识库的四步推演
假设某生物医药企业的研发团队处在立项调研阶段,手头积累了几千份论文、PDF、专利文本与临床报告需要整理归档。而大部分资料以双栏排版、扫描附录和带大量数据表的形式为主,团队希望快速回答"某靶点有哪些支持证据""同类药物的关键终点指标如何设置"这类问题。人工逐篇翻阅显然不现实,但是如果直接把 PDF 丢给大模型,问答结果又常常对不上原文。他们希望在不改变现有文献管理办法的前提下,把这些多源资料变成可检索、可问答、可核对的知识底座,供研发与医学事务团队共用。团队引入xParse,作为解析层对文献做批量结构化处理,保留表格行列、公式与阅读顺序,输出Markdown与JSON后再接入向量库与RAG知识库。对扫描件先做图像预处理,再进入解析流程。可实现人工整理的便利,解放重复性工作,科研人员能把时间放回假设验证与实验设计;每一条结论都能回到原文位置核对,而不是停留在一段无法追溯的生成文本。需要说明的是,这只是一个基于产品能力的场景假设,不代表任何企业的实际效果。
AI 制药的资金正在向基础设施集中,而基础设施的起点,往往是一篇被正确读懂的文献。
点击下方图片,了解更多合合信息有关TextIn xParse产品的信息。
本文所有产品性能效果和案例数据仅供参考,均不作为履约依据,具体效果请以贵司实测为准。