筑牢金融知识库:先让TextIn xParse帮你读懂复杂金融文档
制度查询、合规资料查找和投资研究,都离不开专业信息的获取与复用。对金融机构来说,长期积累的制度文件、业务资料与研究材料,是重要的知识资源。智能应用建设中需要解决的问题是如何让这些已有资料持续服务业务。
假设某基金公司围绕内部管理和投资研究两类需求,一边需要推进内部金融知识库与投研知识库建设,为资料检索、知识问答等应用准备内容。另一方面,结合自建平台,探索OA智能助手、知识问答以及研究报告生成Agent等应用。这些应用各有侧重,但落到文档处理环节,都是需要先把原始资料转化为系统能够使用的结构数据。为此,客户引入合合信息TextIn xParse的文档解析能力,为后续的内容切分、信息抽取和检索提供基础的技术支持。
建设金融知识库并不只是把文件集中存放,而是要让文档真正参与检索与问答,同时解决资料查找、内容提取和模型接入中的实际问题。
建设金融知识库面临的三类实际难题
一、资料分散,查找与整理依赖人工
制度文件、业务资料和研究材料一般沉淀在不同位置,如果我们需要查找一项规定或者整理一家公司的研究信息,往往需要反复翻阅文件、摘录内容,再核对相关说明,这对我们人力资源的消耗无疑是很大的。基于大模型的智能问答,为这些资料提供了更便捷的使用方式。当用户用自然语言提问,系统识别并检索相关内容,组织回答问题,就能减少反复翻阅文件的工作量。但是我们也需要额外注意,如果要让回答有充分依据,那么就要求系统先把信息读完整。
二、复杂内容提取不完整,影响后续检索与理解
在实际业务中,往往会出现以下情况,当你需要查询某项业务的收入占比,相关信息的呈现可能出现在一张堆叠图中。或者当你查找某个报告期的现金流数据,需要同时对应正确的财务科目、年份和单位等。由此,我们可以看出,回顾一页研究演示中的分析观点,必须要同时结合旁边的支撑图表。如果图表只留下图片、表格丢失表头关系或者PPT 的说明与图形分离,后续系统拿到的就可能是不完整的信息。即便检索到相关片段,也可能因缺少数据归属或上下文,难以组织出完整的回答。
三、历史资料与新增内容并行,处理效率同样重要
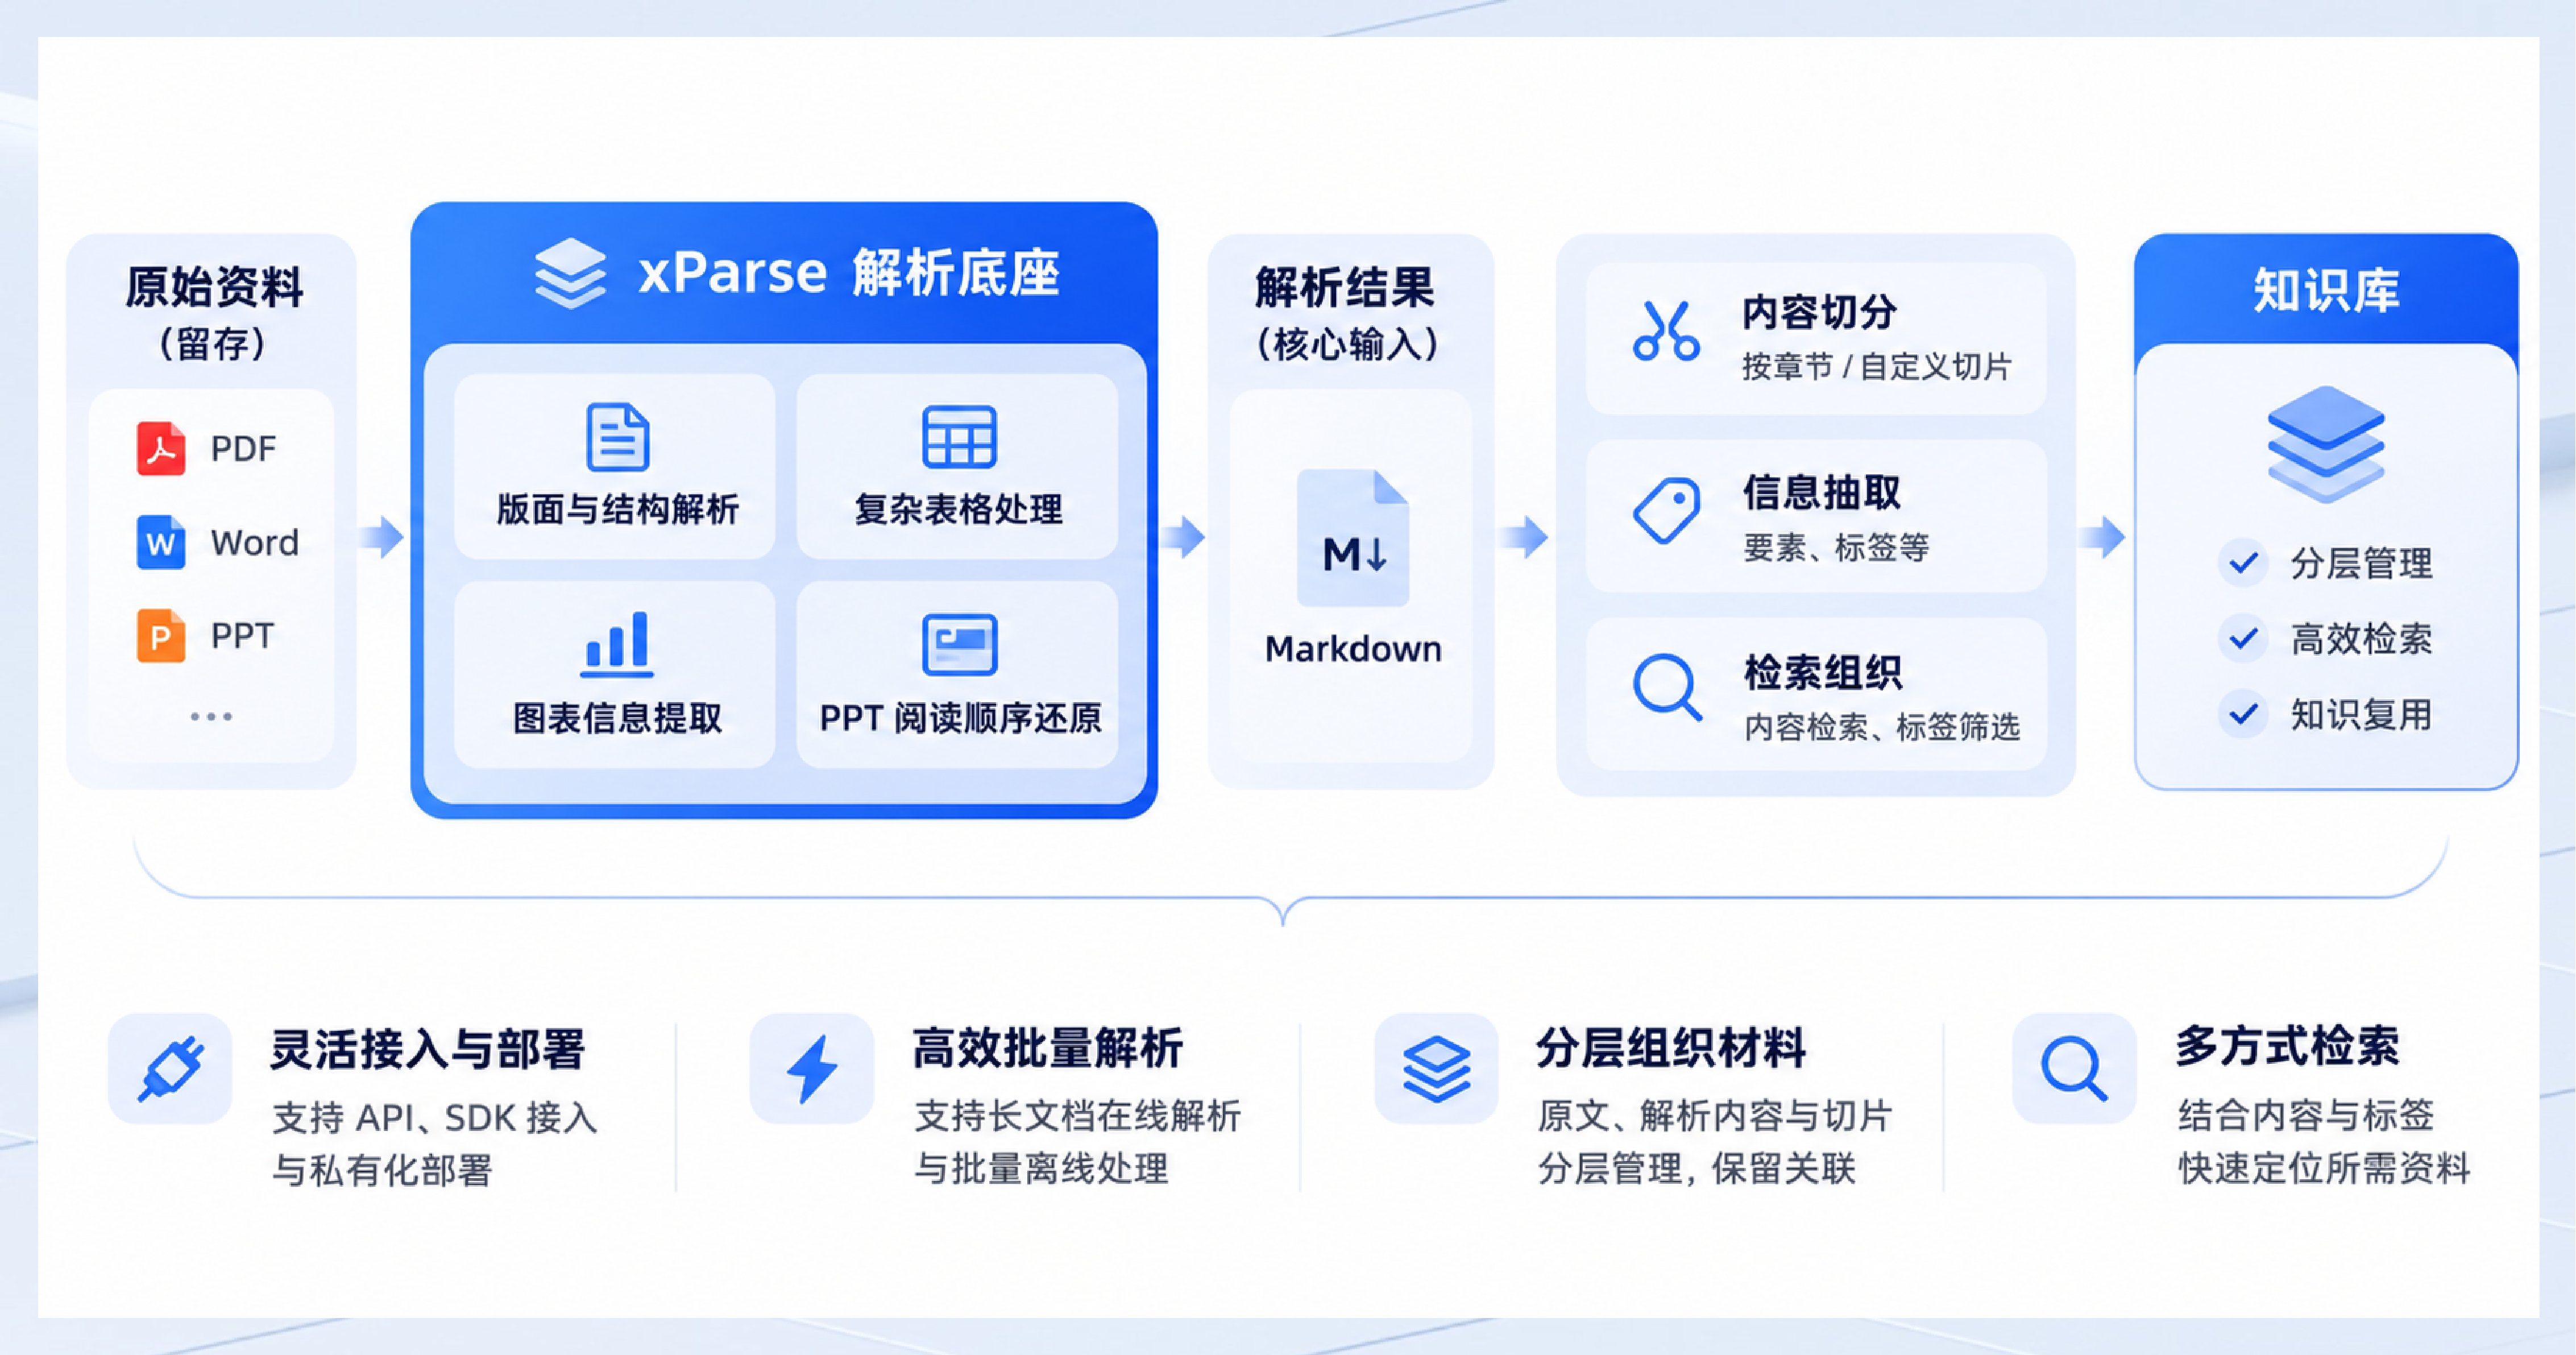
知识库既要整理已经积累的材料,也要持续接收新增内容。在开发阶段,人工核查部分结果还尚可。但随着资料不断增加,我们也必须同时考虑逐份检查难以持续,解析效果与处理效率等现实因素。为了满足这些需求,xParse 向客户提供文档的内容与结构信息,并结合金融图表增强、复杂表格的还原、PPT 阅读顺序识别等能力,为复杂资料的进一步利用提供支持。在客户的建设方案中,原始文件用于留存,解析后的 Markdown 作为知识库的核心内容输入,围绕解析后的内容完成信息切分、信息抽取和检索组织等。
建设知识库的过程中如何让文档解析落地?
一、灵活接入与部署,融入企业现有系统
TextIn xParse可通过API、SDK等方式接入企业已有的知识库平台和业务系统,把文档解析能力融入资料处理流程,并可根据项目要求采用私有化部署,为内部知识库与投研知识库建设提供解析服务。
二、高效批量解析支撑基础数据建设
金融知识库建设既需要集中处理历史资料,也需要持续接入新增内容。xParse 支持长文档在线解析与批量离线处理,100页文档仅需1.5s,500万页快至3天,兼顾单份长文档的快速处理与大规模资料的批量解析,为知识库建设和持续更新提供高效支撑。
三、分层组织材料,保留文档与内容片段的联系
在建设金融知识库的过程中,我们需要参考分层知识管理的思路,把原始文档、完整解析内容和切分后的内容片段分别组织,并记录相关节点之间的联系。在切片时利用目录与标题层级确定内容边界,尽量避免把一段完整说明拆得过碎。
四、结合多种检索方式,让资料更容易被找到
在解析和切片的基础上,进一步抽取核心内容整理为标签;检索时既查找原始内容片段,也利用标签等信息综合筛选相关资料。
通过上述流程,xParse 的文档解析能力与客户自建的知识组织、检索机制相衔接,让分散的资料逐步成为可查询、可复用的知识内容。
哪些场景需要用到复杂的文档解析?
研究人员查询一份报告时,答案未必写在正文里,也可能藏在图表中。如果没有提取到这些信息,知识库即便收录了整份报告,也未必能回答相关问题。
一、金融图表增强
以一份宏观经济报告的问答测试为例,用户提问:“哪些经济体的家庭储蓄率低于疫情前平均水平?”这一问题的具体答案来自报告中的图像。在未进行图表增强时(中图),系统未能提取所需的图表数据,生成了缺乏依据的回答,返回结果与原图不符,其中部分国家甚至未出现在该图中。而进行图表增强后(右图),系统快速定位到图片并提取相关信息,准确给出图中低于零基准线的三个经济体。
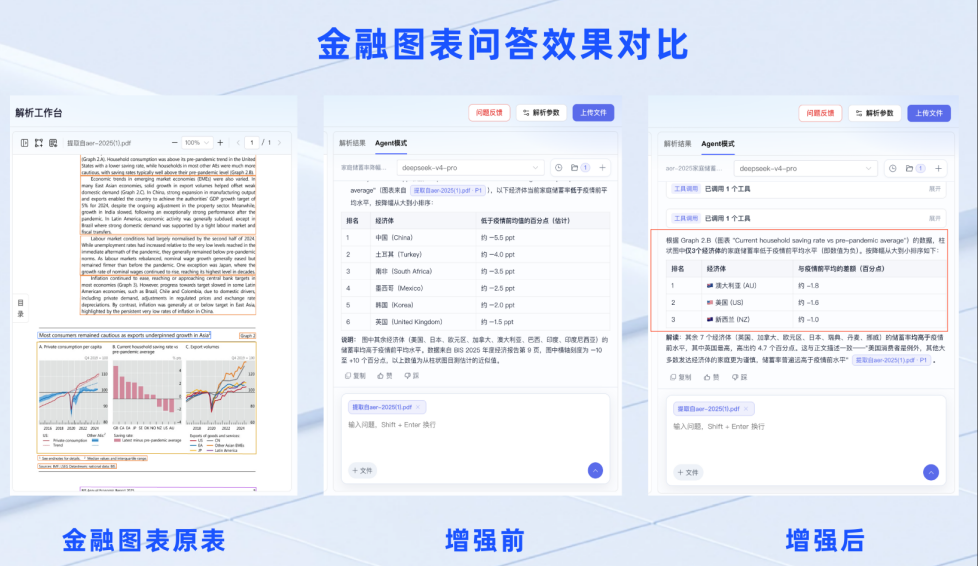
对投研知识库而言,完整的内容输入是形成有依据回答的重要基础。xParse 通过金融图表解析模板,把指标、类别和数据之间的关系整理为可检索的内容,然后纳入文档解析结果,让图表信息真正参与检索过程。
二、财务三大表解析
报表里的数字归属清楚是财务指标查得准的首要前提,以查询“某公司上一年度的经营活动现金流量净额”为例,系统需要同时识别财务科目、报告期间和计量单位,这正是金融表格解析需要重点处理的问题。在面对资产负债表、利润表、现金流量表等财务三大表,xParse 处理密集数字、多层表头和合并单元格等复杂内容,保留科目、期间与数值之间的对应关系,对于跨页延续的表格,则结合跨页合并能力衔接连续信息。
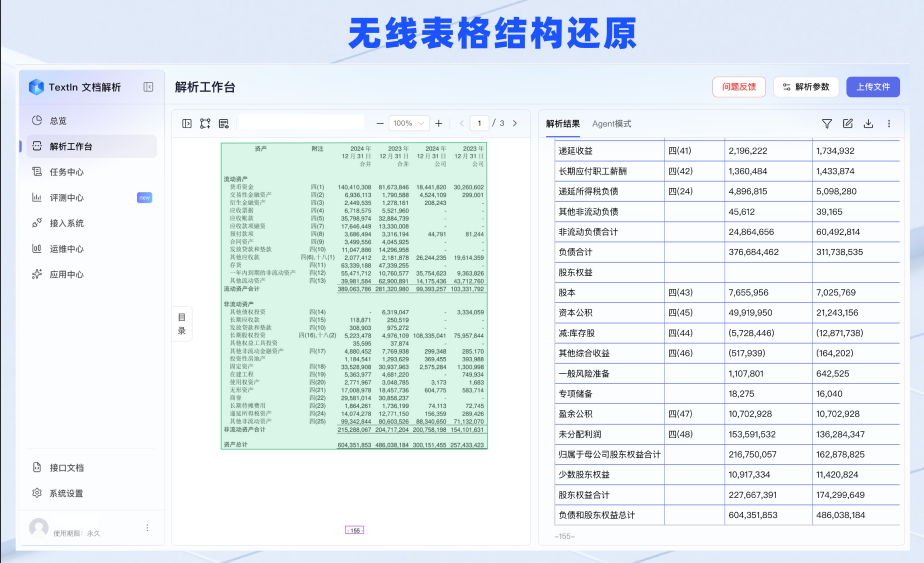
对金融知识库建设而言,保留清晰的行列结构关系,能为后续指标抽取提供更明确的字段依据。
三、PPT 阅读顺序识别
PPT 格式的投研文档与连续排版的正文相比,往往需要通过页面布局表达逻辑。例如,一页演示材料左侧介绍经营变化,右侧放置对应图表,底部说明统计口径,如此一来,对研究人员来说这就是一组完整的信息,但如果解析后只剩下顺序混乱的文字,那么观点、数据和说明之间的联系就很可能被打散,就会对研究人员的信息获取造成很大的障碍。一旦零散混乱的信息进入知识库后,这种问题也会延续到其他的应用场景。因此,PPT 解析需要关注的不只是文字识别,还包括按照页面的内容关系,组织标题、正文、图表与注释。
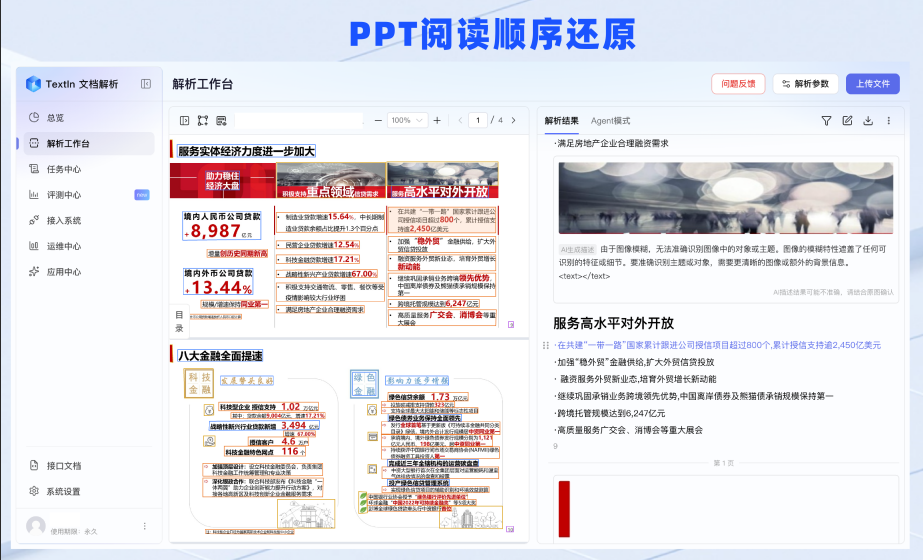
xParse 把复杂文档中的文字、表格和图表信息整理为结构清晰、便于加工的内容,为客户后续的切片、检索与问答提供更完整的依据。在此基础上,客户通过自建的知识组织与应用系统,让分散的制度文件和研究资料服务于内部查询、信息核对与投资研究。同时,兼顾效果与效率的解析能力能够支撑历史资料整理和新增内容接入,为金融知识库持续更新提供支持,推动文档从被保存走向被使用,让积累的知识真正服务业务。
点击下方图片,了解更多合合信息 TextIn xParse与打造金融知识库的产品内容信息。