让大模型把文件读“对”,先得把版面拼回去
让大模型处理文件,开场几乎都一样:合同、年报、投标文件传上去,等它读完给结论。文档解析这一层,往往就在这时候被跳过。
传上去的到底是“文件”,还是一串按坐标排好的字符?这两者差着一整层版面的关系。
合合信息 TextIn xParse 站的就是这一层,作为通用文档解析,它做的事说起来简单:在文件进门之前,先把其版面拼回去。
xParse 接手的时候,文件已经散了一半
PDF 的页面不是文字容器,是一组绘制指令。它只记得每个字画在页面的哪个位置,不记得这个字属于哪一段、哪一列。把文字取出来,得到的是一串字符,段落和栏的关系要靠位置重新推。
可一碰到复杂版式,事情就复杂了。
双栏排版,两栏文字在坐标上贴得很近,取出来左右交替,句子被切成两半再拼回去;跨页表格,表头只在第一页出现,续页的行数据找不到自己的列;图文混排,图一抽走,“如图所示”就没了指向。
扫描件还要多一道。电子版的段落层级写在样式表里,有据可查;扫描件和拍照件只剩像素,连字都得先认出来。同一批材料里两种文件混着来,文档解析得同时按两种读法处理。
一次文档解析,xParse 把它拆开做:先排顺序,再分层,表格单独按结构给,最后给每一条结果贴上位置。
这几步走完,模型拿到的才是一份“文件”,而不是一堆字。
第一步,把阅读顺序排回来
人看一份年报,眼睛先做了一件事:把版面理清楚。哪一段属于哪一节,哪个数字属于哪一列,不用过脑子。文档解析要做的,是替模型把这一步补上。
它认双栏、三栏和图文混排的阅读顺序,版面分析把标题、段落、列表、页眉、页脚、脚注、水印分开。多栏页面上,两栏不再左右穿插。
这一步最要紧。顺序错了,后面的检索、切片、问答,全在错位的文本上继续错下去。
第二步,把元素按层分开
文本、表格、图片、公式、印章、手写体、二维码,16 类以上内容元素分开输出。
类目多少不是关键。关键是每类元素知道自己属于哪一层,下游能按层取用——要正文就不要页眉,要印章就单独拿印章。
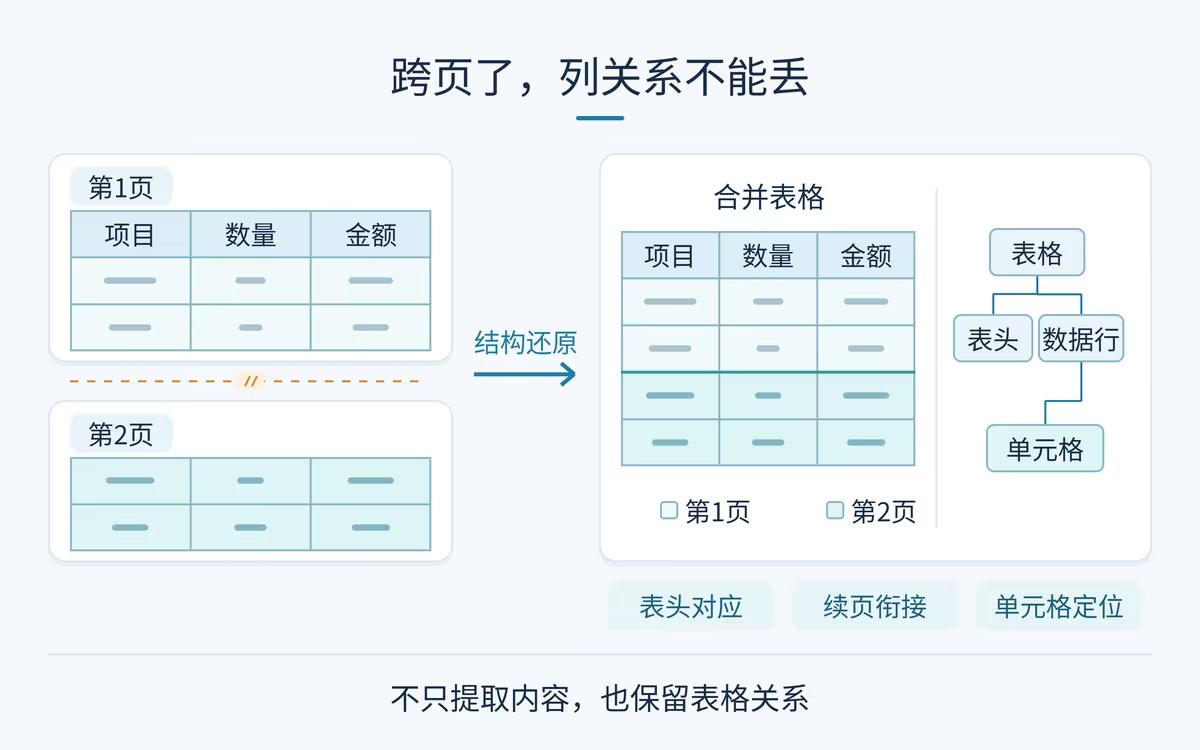
表格是文档解析里最难的一段。有线表、无线表、合并单元格、跨页长表、嵌套表头,xParse 都认,输出的是表格树和单元格几何属性。
跨页表的续页关系留在结构里,表格能被比对,而不只是被读出来。
第三步,给每条结果贴上位置
文档解析的输出支持页面、段落、字符级定位,JSON 里保留页码和 BBox 坐标——BBox 就是内容在页面上的位置框,相当于给每一段贴上“第几页、什么位置”的标签。
有这一条,结论才回得去原文。答案说得再顺,指不回原文,也只能当参考。
拼回去之后还能接着问。在解析结果之上,xParse 提供受证据约束的问答,回答依据解析结果给出,结论能指回原文位置。证据链不在中途断开。
速度也跟得上。常规印刷文字识别率 99.77%,表格识别率超过 99%,复杂文档综合还原度 95%;百页长文档在线解析最快 1.5 秒,离线批量 3 天能解析 500 万页 PDF;日均支撑数百万级调用量,成功率 99.999%,支持 52 种以上语言。
拼回去的数据,还得进得了系统
文档解析是一道工序,不是终点。xParse 的输出有两种形态,各有各的去处。
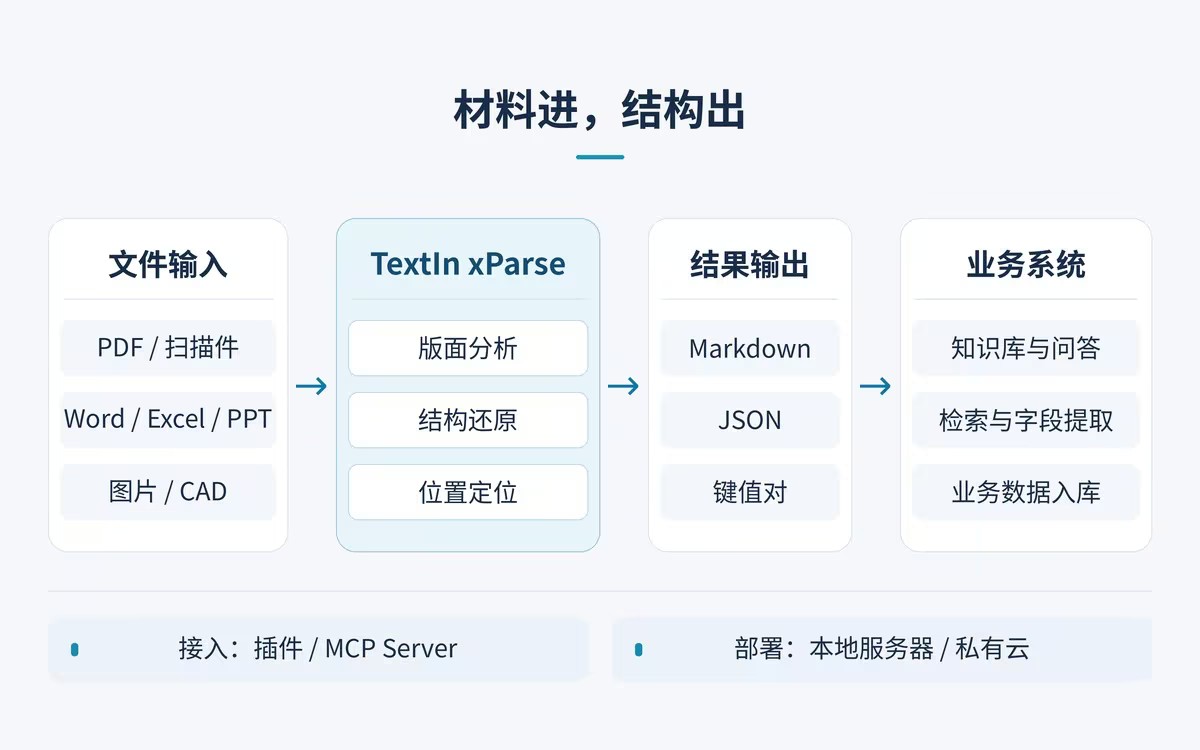
进知识库:Markdown 承载连续阅读内容,适合大模型问答;JSON 保留结构和位置,适合程序取字段。
进检索:搜索级、实体级两种分块,按检索语义切,不按字数硬切。版面关系在分块之后还留着,检索到的片段才不缺上下文。
进业务系统:键值对形态直接落库,字段和解析结果一起进去。少一次人工整理,就少一处录入差错。
入口也够宽。文档解析的输入范围覆盖 PDF(含加密件、扫描件)、Word、Excel、PPT、图片、CAD 图纸,网页截图、手机长截图里的信息也能提出来。
xParse 怎么进入企业现有的流程
对于已经搭好智能体应用、知识库或检索流程的团队,插件和 MCP Server 两种形态都能直接对接。用什么框架搭的,就顺着哪条路走。
数据不想出内网的,本地服务器或私有云部署,xParse 的解析过程和结果都留在内网。
接入之后,它不是一个要单独登录的系统,而是流程里的一个节点:材料进,结构出。
数百页的投标文件,是 xParse 的面试场
以某地公共资源交易机构为例。一个项目下来,招标文件、投标文件、澄清文件摞在一起,版本还在变,投标文件动辄几百页,电子版、扫描件、图片混着来。
对此,可以接入合合信息TextIn xParse,材料上传后自动完成解析与结构化:招标文件的资格条件与评标办法、投标文件里的资质业绩与报价,整理成可对照的数据;澄清文件更新,相关条款同步迭代。预期是人工翻阅和重复录入减少,条款漏检、版本误用的风险跟着下降。
回到开头。文档解析补的正是输入质量这一课;任何要“让大模型读文件”的团队,这一关同样绕不开。
毕竟,人看到的是一份版面完好的报告,模型拿到的是一份说得清位置的数据——这才谈得上“读懂”。
点击下方图片,了解更多合合信息通用文档解析产品TextIn xParse的内容信息