档案数字化就是扫成图片?结构化解析才是真落地-合合信息解决方案
2026年10月9日,国家档案局启动“十五五”时期深化企业集团数字档案馆(室)建设试点,明确要求“加强档案数字资源建设,持续推进传统载体档案数字化”。然而,很多企业将库房积存的合同、凭证、工程资料等批量送进扫描仪,产出的却只是一张张图片格式的PDF:跨页表格被拦腰截断、印章与正文叠成像素块、页边手写批注语义断裂......其实,档案数字化的价值从来不在扫了多少页,而在文档结构还原到什么程度——没有结构的扫描件只是存放在硬盘里的“电子纸质版”,无法谈及检索复用。
扫描件无法高效利用的根源:版面结构随成像丢失
扫描的本质,是把带有物理层级、逻辑关联的纸质文档,压成了二维的像素集合。原本清晰的标题层级、表格行列对应关系、跨页连续的段落、印章的专属位置、边栏的手写批注意见,都在扫描成像的那一刻丢失了语义标签,只剩不同颜色的像素点。
很多项目团队以为做完档案OCR就完成了数字化,实则普通的文字识别只能输出零散的纯文本,既分不清标题与正文的区别,也理不清双栏排版的阅读顺序,更接不上跨页断开的表格内容。所以,若仅做基础档案OCR、输出无结构纯文本的方案,最终档案检索的命中率往往不高,搜一个合同编号可能会带出几十张文件名相近的扫描页,仍需人工逐页核对内容。对不少档案管理员来说,找文件只是从“翻库房纸页”变成了“翻电脑文件夹”,效率没有本质提升。
从像素到可复用数据,需要还原哪些文档要素?
要让扫描后的数字资源真正可用,核心是把扫描时压平的文档逻辑重新“立起来”,需要识别还原的要素覆盖多个维度:先是版面逻辑,针对双栏三栏公文、带侧边批注的卷宗、混有页眉页脚的正式文件,要先梳理出正确的阅读顺序;再是内容层级,要精准区分一级标题、二级标题、正文段落、有序无序列表,不能把所有内容混成无差别的文字流;最后是特殊元素,公式、水印、插图、页码的位置都要精准标记。
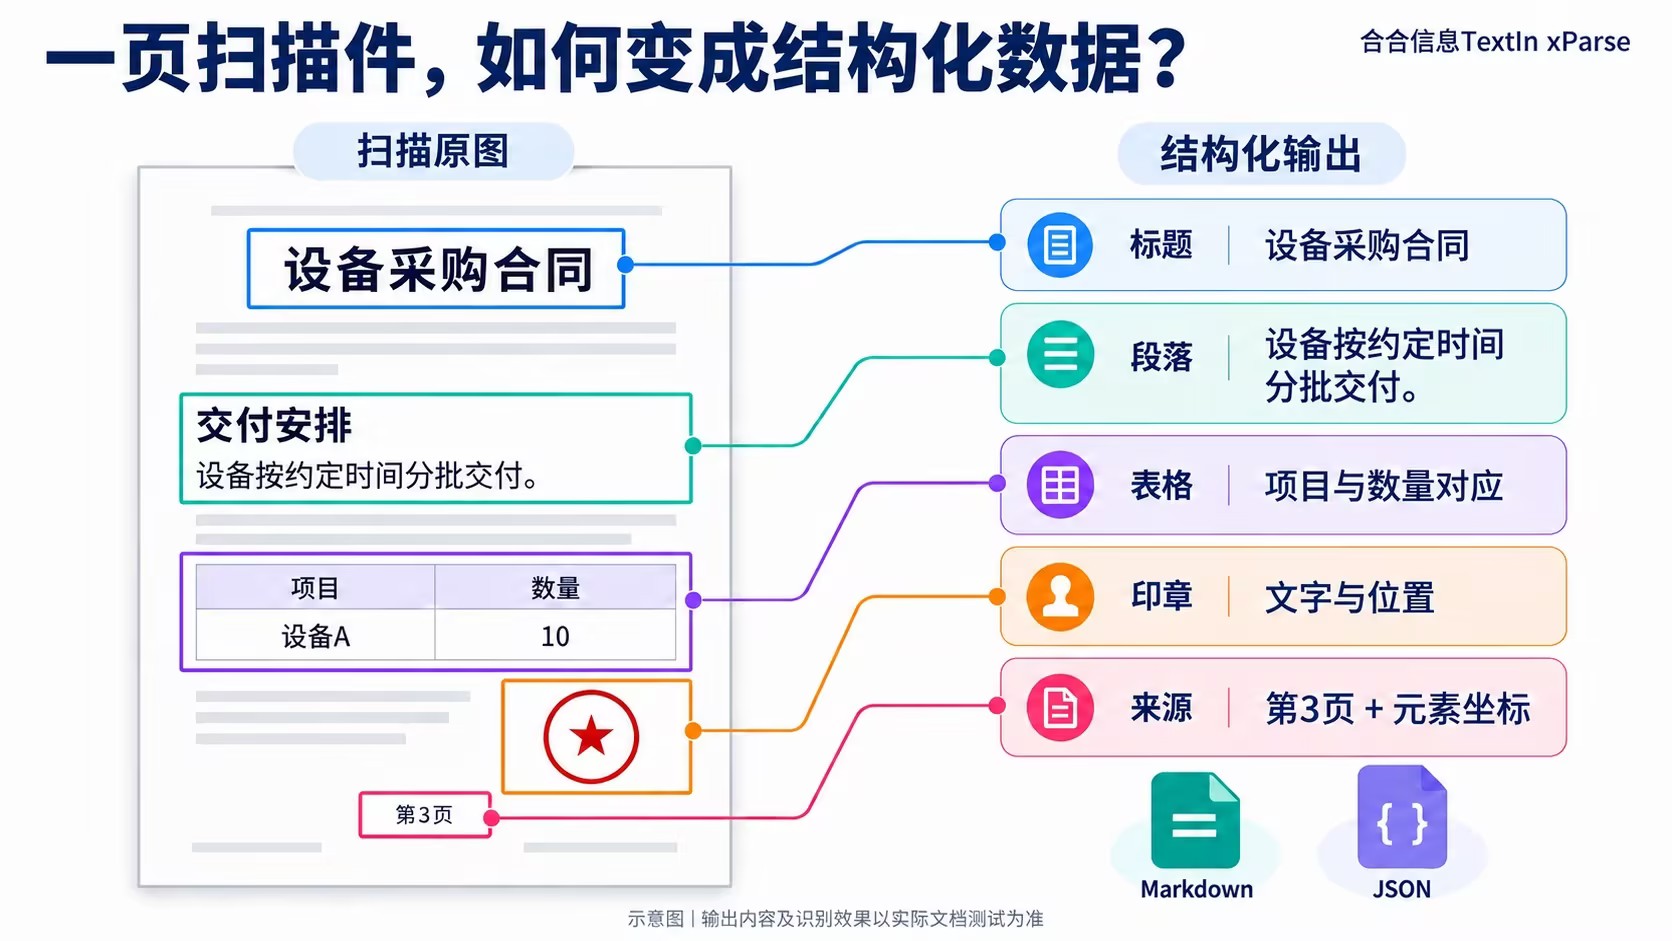
针对这些痛点,合合信息TextIn xParse给出了体系化的解决路径。作为通用文档解析引擎,TextIn xParse可将 PDF、扫描件、图片等非结构化文档解析为 Markdown、JSON 等结构化数据,直接对接检索、知识库与大模型应用。它能自动完成扫描件识别与版面分析,还原标题、段落、列表、页眉页脚、脚注、水印等常见文档元素,适配双栏、三栏、图文混排等复杂版面,输出时保留对应页码与元素坐标,每一段文字、每一个模块都能对应到扫描原图的具体位置。
复杂档案场景下,TextIn xParse解析能力覆盖特殊需求
档案类文档的复杂度远高于普通电子文档,针对档案高频场景,xParse具备对应的专项能力:
复杂表格完整还原。会计凭证里的无线表、工程图纸旁的参数表、跨数十页的合并单元格长表,通常是普通文档解析的难点。而xParse支持有线表、无线表、混合表、跨页长表等多种表格类型的识别,能精准对应行列关系,不会出现跨页断行、内容串行的问题。
印章与手写体识别。公章、收签章、领导手写批示往往是档案的核心检索维度,xParse支持提取印章的位置与印文内容,也能识别潦草、连笔的手写批注,无需人工逐页标记。针对有涉外业务的企业,它还支持52+种语言的档案OCR识别,外文合同、进口设备资料也能统一处理。
解析结果可溯源。xParse输出的所有解析结果都绑定原文档页码与元素坐标,档案入库前复核时,工作人员可以一键跳转到原文对应位置,不用手动翻页查找,大幅降低校验成本。输出的Markdown、JSON格式也能直接对接全文检索系统、企业知识库与大模型相关应用,减少中间数据清洗的工作量。
集团数字化批量落地,xParse帮助平衡处理效率与档案安全
集团级档案数字化项目往往规模达百万甚至千万页,处理效率与数据安全是项目负责人最关心的两个核心问题。
效率层面,xParse的处理能力可匹配不同规模的项目节奏,它对100页的长文档在线解析能够快至1.5秒;离线批量处理场景下,3天还可完成500万页文档的精准解析,不会拖慢整体项目工期。
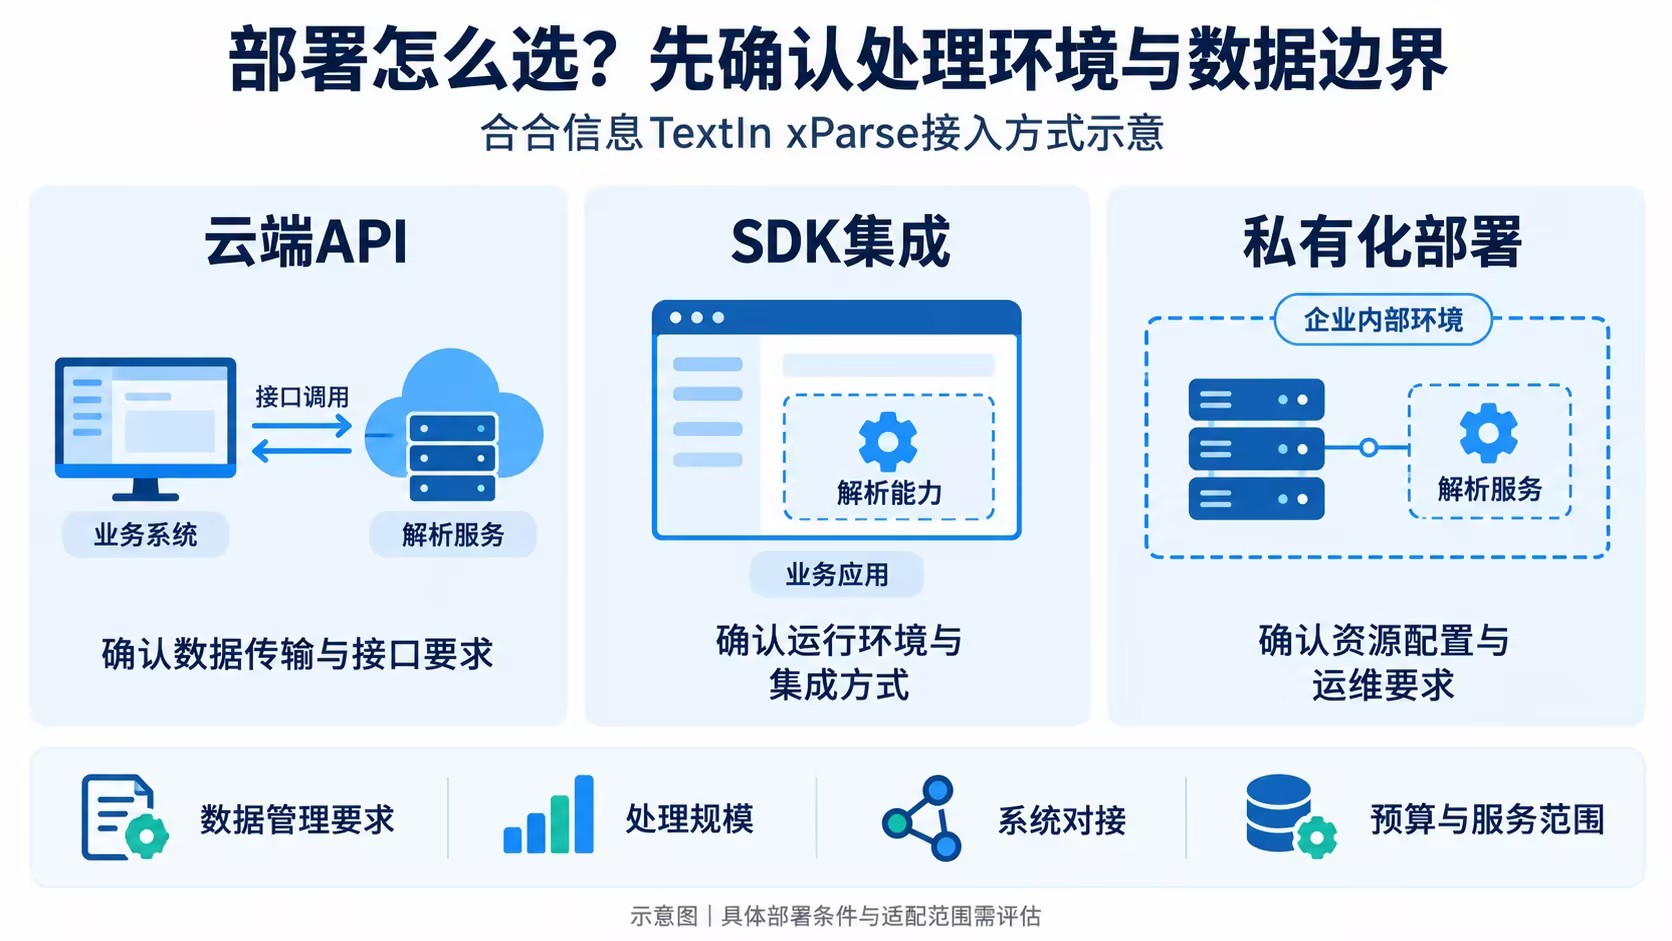
部署层面,xParse提供云端API、端侧SDK、私有化部署三种接入方式,支持国产信创设备,企业可根据项目预算、档案密级灵活选择。
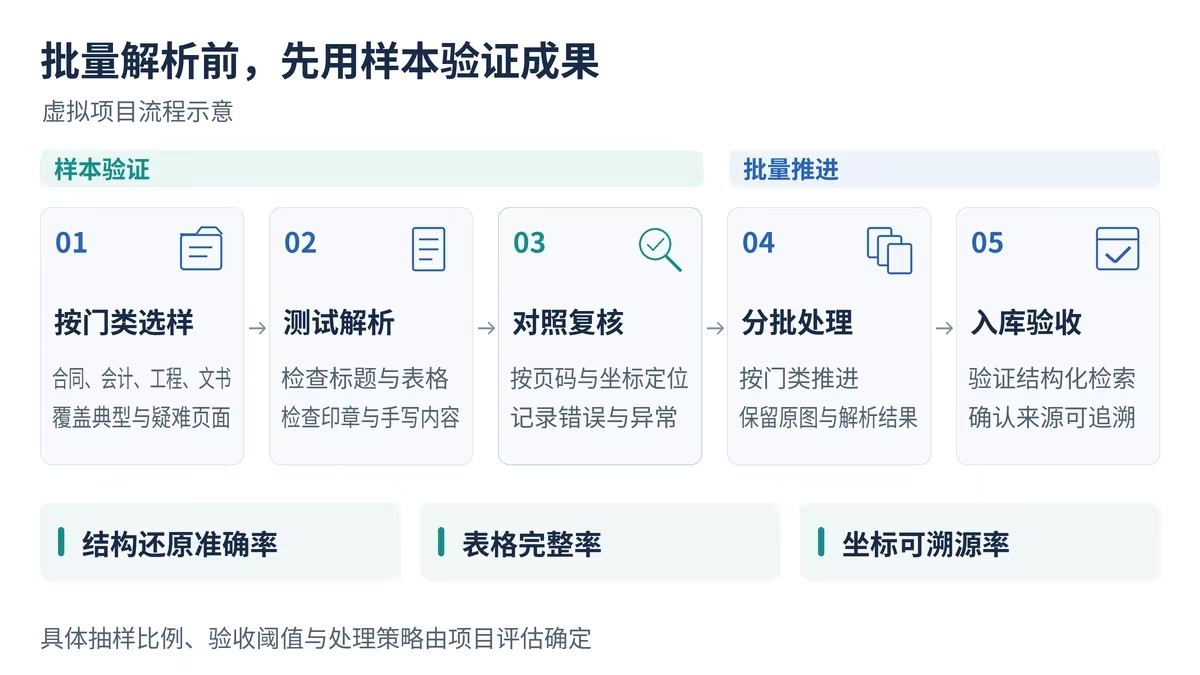
企业团队可以先提供样本做效果评估,不应仅把“扫描总页数”作为项目核心验收指标,更应将“结构还原准确率”“表格完整率”“坐标可溯源率”纳入验收标准,避免项目做完数字资源却无法复用。
xParse帮助企业集团实现存量档案数字化落地
以某跨区域经营的大型企业集团为例,其启动“十五五”首批数字档案馆建设,计划完成旗下多家二三级单位近20年的存量纸质档案数字化,覆盖文书、会计、工程、合同四大门类,总规模超百万页。若仅进行扫描与基础文字识别,产出的图片型PDF往往存在跨页表格断裂、印章无结构化标记、多栏版面顺序混乱等问题,不仅无法实现全文检索,人工逐页复核的成本也成为拖慢项目进度的卡点。对此,可以引入合合信息TextIn xParse,帮助完成批量扫描件识别与结构还原,企业团队还可按档案门类分批校验,可以先抽取1%的代表性样本做解析准确率测试,调整适配参数后再全量跑批,所有输出结果保留原页坐标与结构标签,直接对接集团现有档案管理系统。全量解析完成后,所有档案可支持标题、正文、表格、印文多维度结构化检索,人工复核还可通过坐标一键定位问题位置,复核效率预期能够得到提升,后续一线业务的档案调阅响应时间也能实现压缩。
如果你的企业团队正在推进存量档案数字化项目,想要评估扫描件识别、档案OCR与结构还原的实际效果,可以使用合合信息TextIn xParse进行测试,验证其文档解析、提取和定位溯源的实际效果。点击下方图片,了解更多合合信息TextIn xParse文档解析产品的内容信息。