招标文件信息抽取怎么做:零样本抽取与坐标溯源-合合信息解决方案
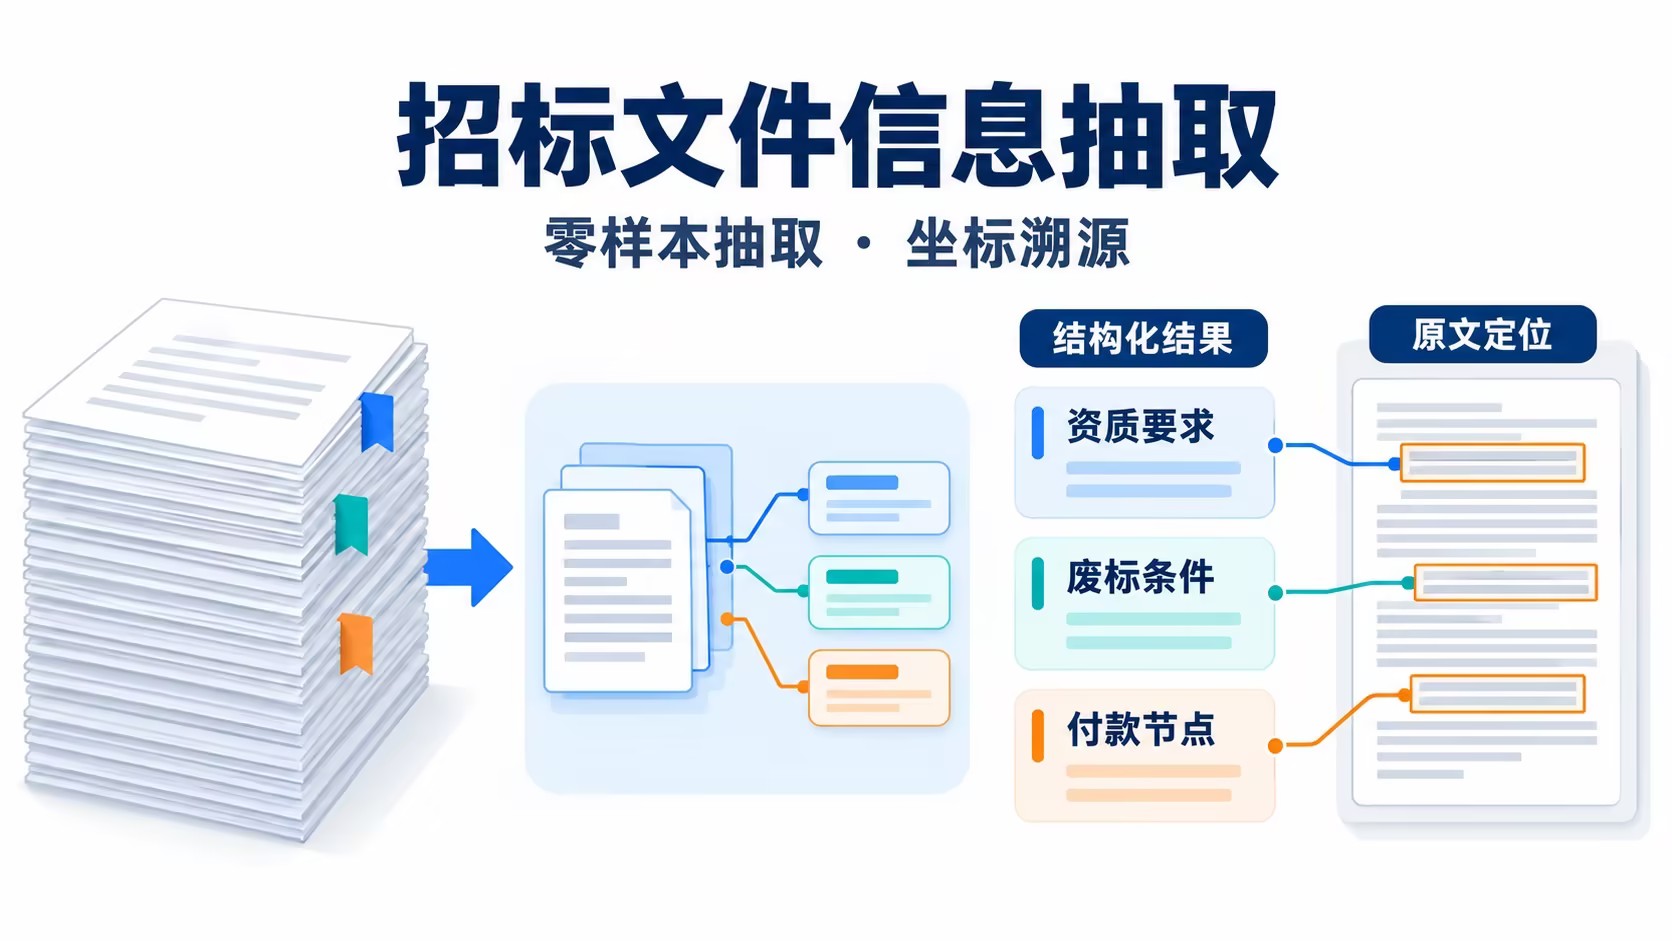
2026年10月,通信、能源电力等行业的多家大型企业先后披露招采领域AI能力清单,覆盖招标合规审查、废标风险分析等8类业务场景,其中标书审核智能体自动校验招标文件的能力受到较多关注。多数讨论聚焦在AI能否替代法务做合规判断,却忽略了一道决定审核可靠性的前置工序——招标文件信息抽取:数百页文件里的资质门槛、废标条款、付款约定散落在不同章节,没有结构化的字段归类,再强的审核模型也容易因基础数据缺失误判错判。因此,要落地高质量的非结构化文档转结构化加工,零样本关键信息抽取与坐标溯源是不可或缺的两个核心能力。
招标文件的信息缺口,天然来自文档属性
招标文件普遍长达数百页,核心审核信息并非在其中集中排布,比如,资质要求可能出现在投标人须知、技术规范等多个位置;废标条款除集中列在“无效投标情形”章节外,常以“未满足即否决投标”的形式散落在商务标、技术标角落;付款、验收条款则多位于文末合同模板中,前后关联要求可能相隔上百页,像跨页评分表、双栏排版、表格行线缺失等情况也十分常见。
电子招投标场景下的招标文件往往以Word、文本版PDF形态存在,它们均属于非结构化数据,即文件本身有完整文字层,不需要额外OCR识别,但缺少字段级结构关联,换句话说,计算机能读出招标文件中的单行文字,却无法判断哪几句话共同构成一项资质要求,也不能自动拼接跨页内容、归并跨章节关联规则。也就是说,在实际业务场景中,由于文件未经过信息抽取,人工拿到的是前述非结构化数据,往往需要手动翻查,容易漏看散落在不同章节边角的资质要求、废标条款等关键信息;AI直接处理原始文件时,对于这类复杂非结构化文档也无法自动拼接跨页内容、归并跨章节关联规则,容易因信息不全、数据结构未保留而出现错判漏判,从而导致反复返工拉低,甚至引发合规风险与纠纷。
直接用通用大模型,绕不开三个生产级问题
不少企业试图直接用通用大模型处理文件,但其语义理解能力虽可参与抽取环节,却无法满足生产级业务要求,核心短板有三点:
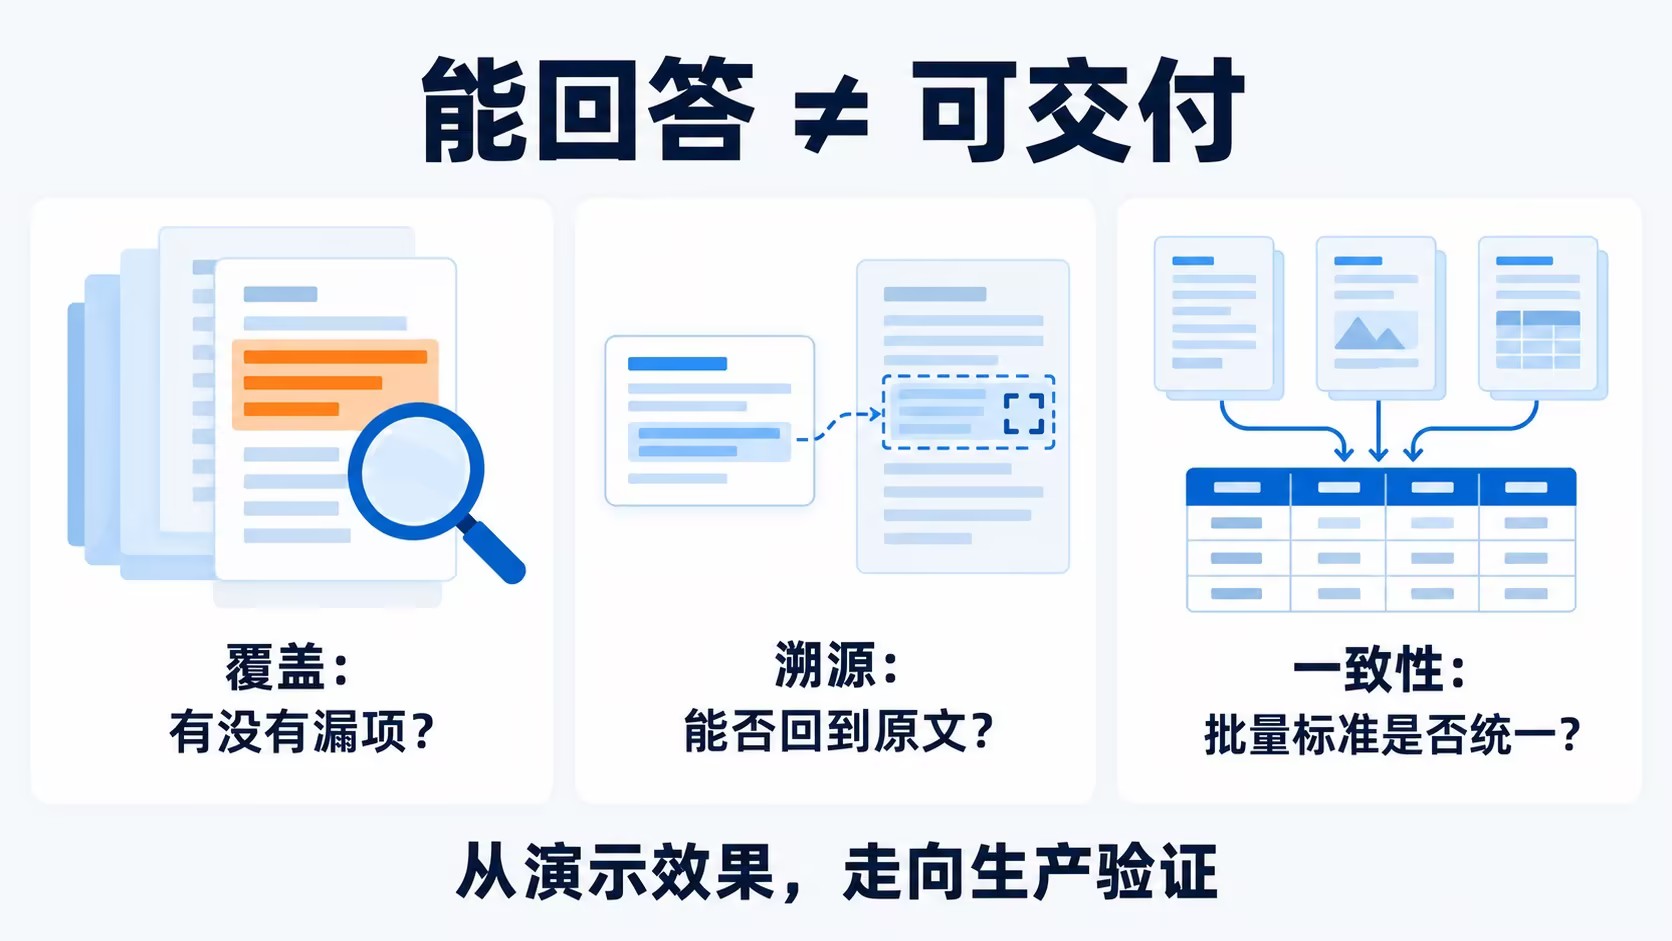
长文档覆盖不足:受长上下文注意力机制限制,通用模型对位置靠后、距离提问较远的内容召回率不稳定,跨页表格、复杂版面的结构信息极易在上下文传递中丢失,直接造成抽项漏项。
结果无法溯源:通用模型可输出字段结论,却不会附带精确的原文页码、位置坐标,而招投标业务要求所有结论可回溯、可举证,无定位的结果无法进入正式审核流程。
批量一致性差:单份文件通过对话调试或许能得到较好效果,但批量处理时输出随机性强,同类型字段归类标准不统一,且逐次调用成本不可控,无法支撑规模化业务。
部分头部企业公开的招采智能化架构,通常会将招采系统沉淀的结构化业务数据,与采购文件、合同等非结构化数据分层设置,这也印证了同一逻辑:非结构化转结构化是独立的必经工序,其质量往往直接决定后续所有AI审核的可靠性。
招标文件抽取选型,盯紧五个可验证标准
评估招标文件信息抽取能力,无需纠结模型参数量、支持格式数等表层参数,可从五个可落地验证的维度判断,覆盖从处理到交付的全链路要求:
长文档覆盖力:支持数百页文件处理,可还原跨页表格、双栏排版、行线缺失等复杂版面,不依赖固定章节位置即可完整召回字段;
表述适配力:无需定制匹配模板、无需标注大量训练样本,通过自然语言即可定义抽取字段,自动识别同义不同表述的行业规则;
跨内容关联力:可关联相隔数十页的语义相关内容,自动拼接跨页拆分的表格,保证字段信息完整无缺失;
结果溯源力:所有抽取字段附带精确原文坐标,支持点击高亮定位原文,无需人工逐页翻找复核;
批量交付力:批量处理标准统一、结果稳定无随机波动,输出通用结构化格式,可直接对接下游审核系统,无需二次加工。
合合信息TextIn:匹配招采场景的落地方案
合合信息TextIn智能文档抽取面向批量长文档结构化场景打造,其核心能力匹配招标文件抽取的生产刚需:支持零样本关键信息抽取,用户仅用自然语言描述字段需求即可启动处理;抽取结果全部附带原文坐标,支持高亮跳转、全链路复核,可稳定承接非结构化文件转结构化对象的前置工序。
对应五大选型标准,TextIn智能文档抽取可支持上百页甚至更长文档处理,内置专业版面解析引擎,可自动还原跨页表格、双栏、缺线等复杂结构,散落在任意章节的资质、废标、商务条款均可完整召回;零样本能力下无需标注样本、配置复杂规则,例如输入“抽取所有资质要求、废标触发条件、付款节点”即可自动处理,还能自动识别“一级/壹级资质”等同义表述,推理抽取隐含要求;通过语义向量建模可实现远距离上下文关联,跨页表格也能自动拼接;所有抽取内容无论段落还是表格单元格,均附带精确坐标,点击即可跳转至Word/PDF原文对应位置,满足招采可回溯要求;还支持离线批量解析,结果标准统一,能够抽取成Markdown、JSON结构化输出,直接对接合规智能体、规则引擎、采购系统、RAG知识库。
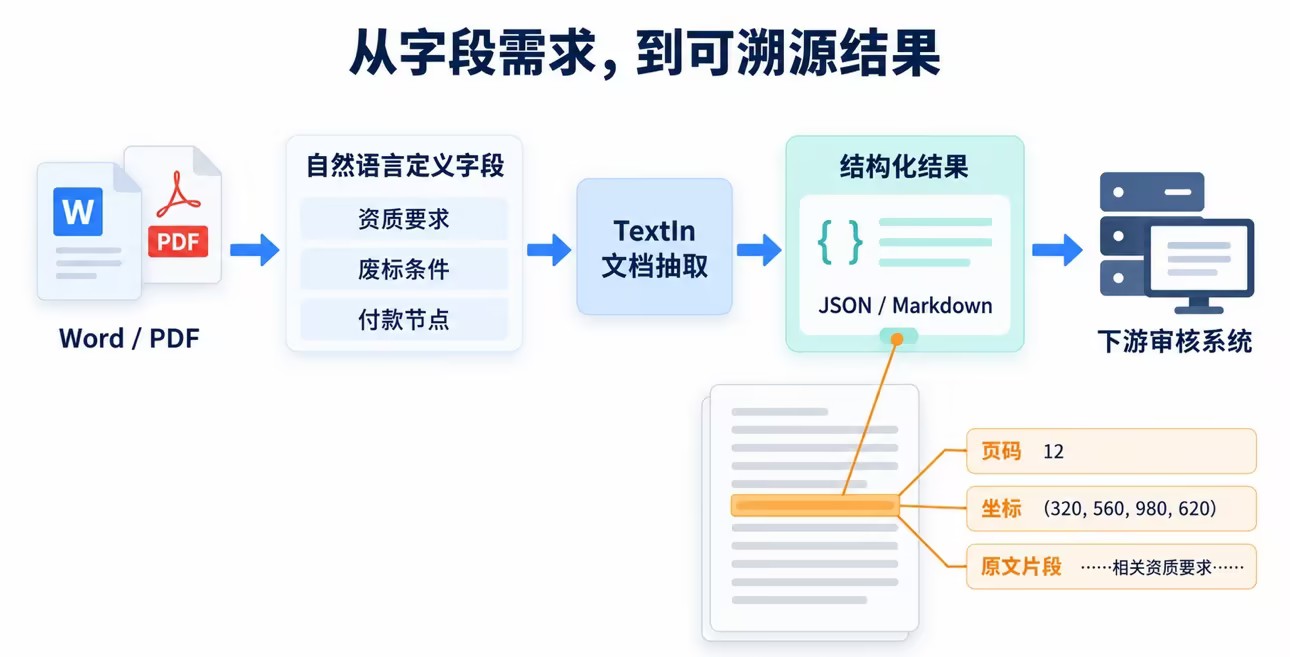
除核心能力外,TextIn智能文档抽取支持近20种格式文档解析,覆盖52种语言,模型训练覆盖工程、法律、政务等多领域行业语料,对招采专有表述适配度高;印刷体识别准确率≥99.77%,百页PDF在线解析最快1.5秒,接口调用成功率≥99.999%,支持百万级日调用量,可满足大规模批量处理需求。产品支持公有云API、私有化部署等多种接入方式,分钟级即可完成单文件测试,且严格定位前置加工环节,仅输出结构化抽取结果,不替代法务或审核系统做合规判断,不越权输出最终审核结论。
TextIn智能文档抽取帮助企业实现智能招标审核落地
以某中大型工程建设企业采购中心为例,其日常需处理大量新增招标文件的审核预处理工作,这类文件往往来自多家招标代理机构,版式模板不统一、资质与废标条款分散排布,传统人工逐页梳理不仅耗时久,还容易遗漏散落在章节边角的否决规则;若采用传统规则匹配工具,则需要针对不同版式反复配置抽取模板,后续模板调整还需同步迭代规则,维护成本高,且整理后的字段无原文定位标记,合规复核时仍需人工翻查全文。对此,可以接入合合信息TextIn智能文档抽取后,不同格式、版式的标书便可通过同一条解析管线批量处理,仅需通过自然语言定义核心审核字段需求,无需逐套适配模板;输出的Markdown、JSON格式结构化结果也全部附带原文坐标,支持定位溯源,可直接对接内部招采审核系统与标书知识库,既降低了人工梳理与工具维护成本,也大幅缩短了审核前的文件预处理周期。
对于正在搭建招采智能审核链路的企业团队,如果面临长文档抽取遗漏、结果无法溯源、批量处理结果不稳定等问题,可使用合合信息TextIn智能文档抽取进行测试,实地验证零样本抽取与坐标溯源的实际效果。
点击下方图片,了解更多合合信息TextIn智能文档抽取的内容信息。