数据彼此不认识,再强的模型也白搭:企业AI落地先过"语义关"-合合信息解决方案
ChatGPT发布以来,企业AI长期比拼模型能力与算力规模。到2026年,模型与算力逐渐进入平台期,企业更关注AI能否进入真实业务流程。在真实业务流程中, AI 调用的是数据:审批要看合同条款,录入要填业务系统,审单要核对发票、运单、回单。但企业大量关键信息仍沉淀在文档里,字段名称不统一、信息分散在不同页面、很多内容靠上下文判断。于是,模型再强,也可能卡在“字段不认识”这一关。智能文档抽取的关键价值,正是先让字段被认识,推动非结构化数据结构化,从而为关键信息提取建立可信底座。
模型与算力走到平台期后,企业开始重新审视“落地”
过去几年,企业讨论AI时常围绕模型参数、推理速度、算力集群展开。随着生成式AI普及,单纯比较模型能力的边际收益下降。行业讨论也在从模型能力转向数据语义。企业数据的价值不只取决于模型强弱,还取决于数据能否被机器理解。把数据丢给模型并不够,字段需要先说清楚自己是谁、属于哪个对象、和哪些信息有关系。因此,企业应当把“字段是否被认识”作为AI项目验收标准之一:字段能否稳定识别?同义表述能否归一?跨页内容能否关联?抽取结果能否回到原文校验?这些问题,直接关系到智能文档抽取能否从演示走向生产。
卡住企业AI的,往往不是模型不够聪明,而是字段没“自报家门”
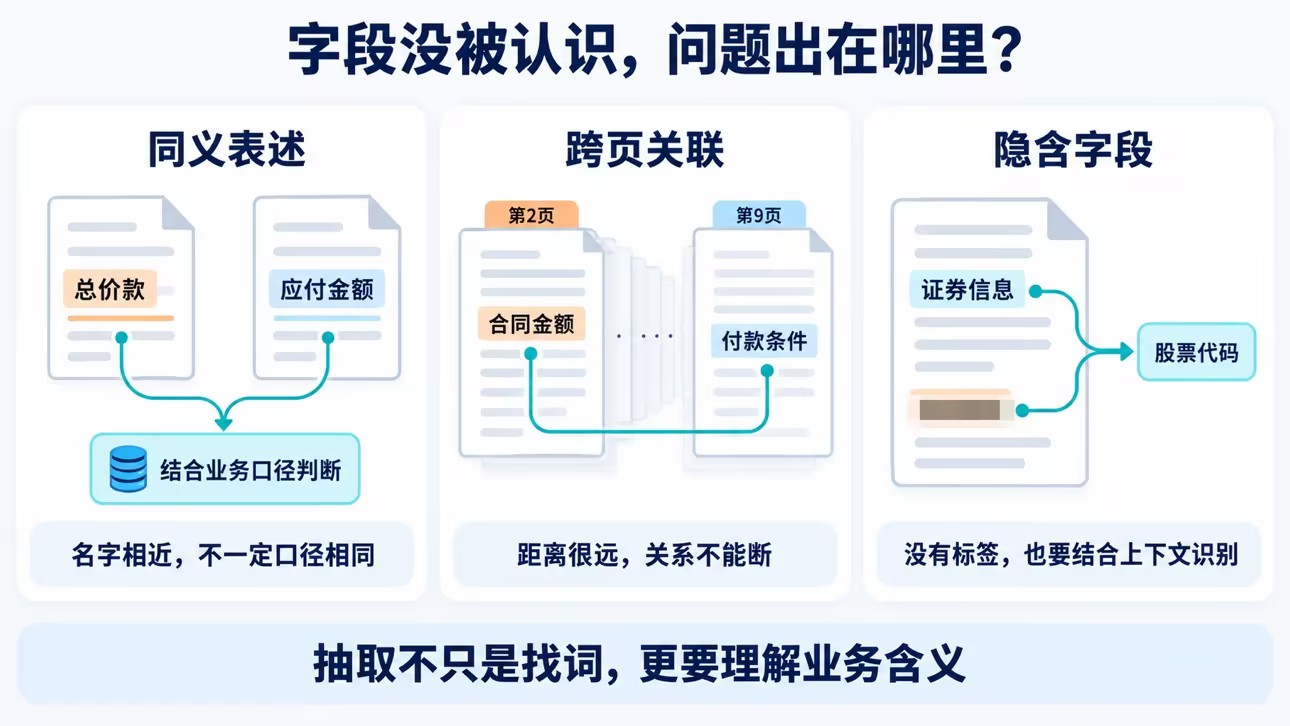
合同、发票、物流单据、财报等业务材料看似都是文字,但字段之间的关系并不清晰。字段不认识,是非结构化数据结构化的第一道门槛。更具体地说,字段级痛点通常有三类。
一是同义表述。采购合同里写“总价款”,发票里写“应付金额”,业务系统里可能叫“应付账款”。如果只做关键词匹配,系统很容易把它们当成不同字段,或者错误合并。智能文档抽取要解决的不只是“找到这个词”,而是判断“这个词在当前单据中代表什么业务含义”。
二则是跨页远距离关联。长文档中,关键信息经常分散在不同位置。合同金额出现在首页表格,付款节点出现在后文条款,执行年度可能出现在附件。若系统只看局部段落,就容易漏掉关系。关键信息提取需要理解“上述金额”“按年度执行”等指代,也需要把相距较远的字段关联起来。
隐含字段是第三个痛点。有些字段不会在文档中显式出现。例如,某些信息没有直接标注字段名,但其格式、位置、上下文已经提示了业务含义,系统应结合语义完成判断。类似地,“年度”也可能有多种表达:完整年度、简写年份、报告期、本年度。零样本关键信息抽取要处理的,正是这类需要语义理解和推理的场景。
从抽取工具到语义接入层:零样本关键信息提取改变了什么
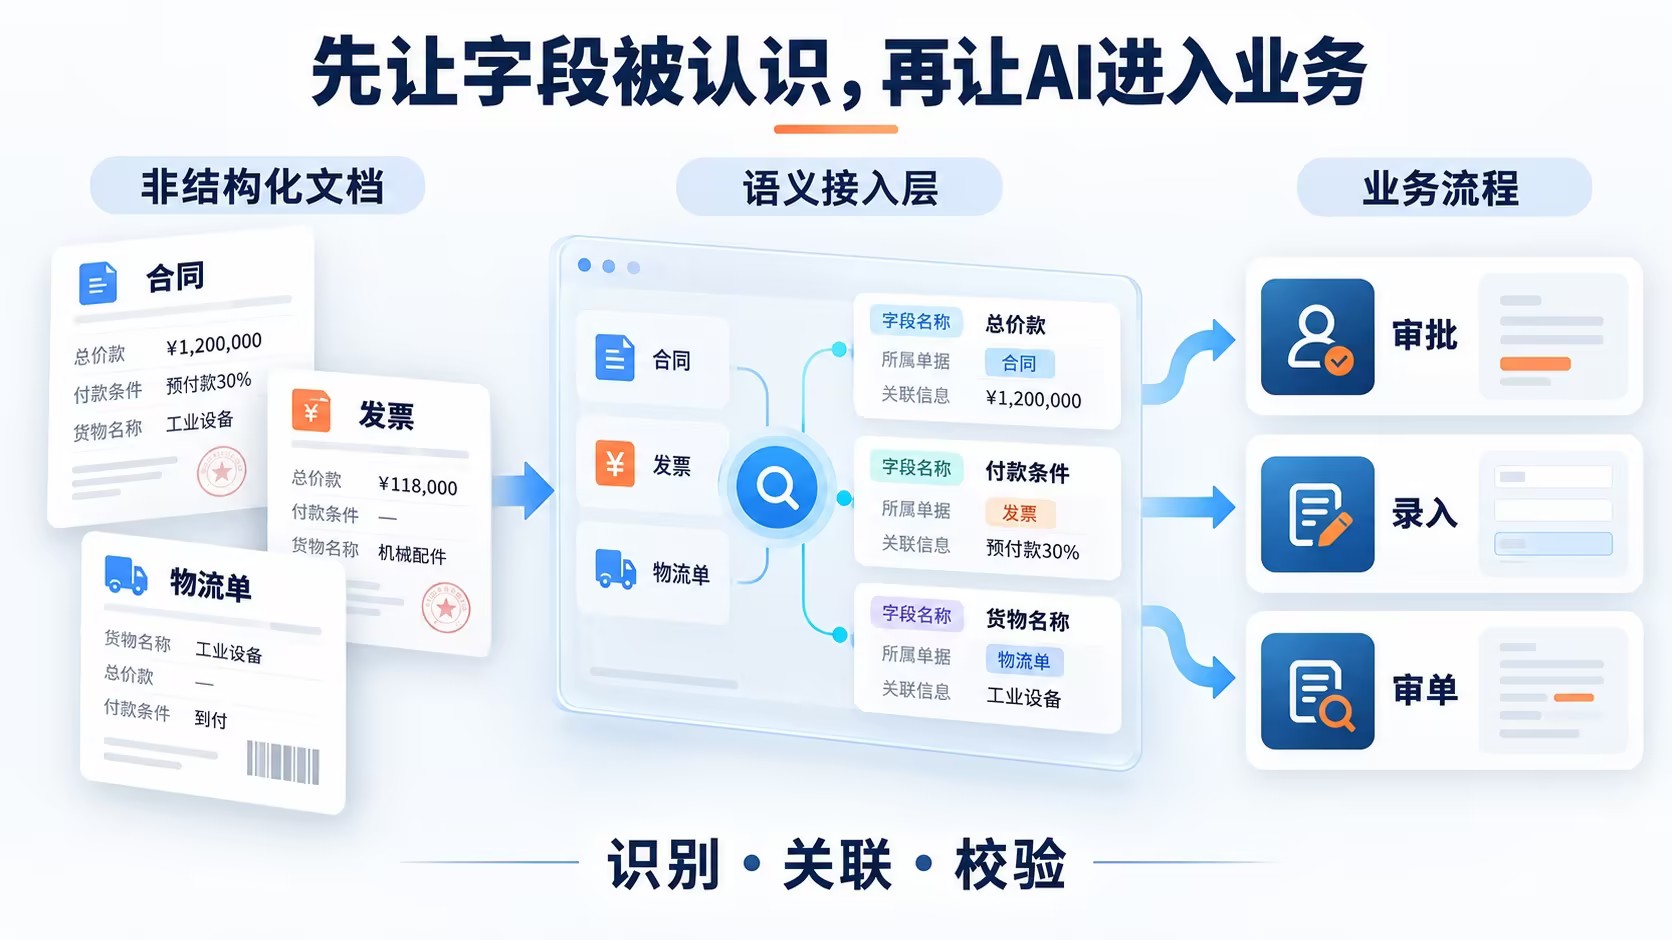
前述痛点正是企业AI要补的课,也是合合信息TextIn把智能文档抽取定位为“语义接入层”而非“抽取小工具”的原因:它要完成的不是“把某个字段抠出来”这一次性动作,而是让每个字段在进入业务系统之前先被识别、被归类、被关联。字段之间的关系补回来,数据才从互不相认的碎片,变成可被系统调用的语义资产。
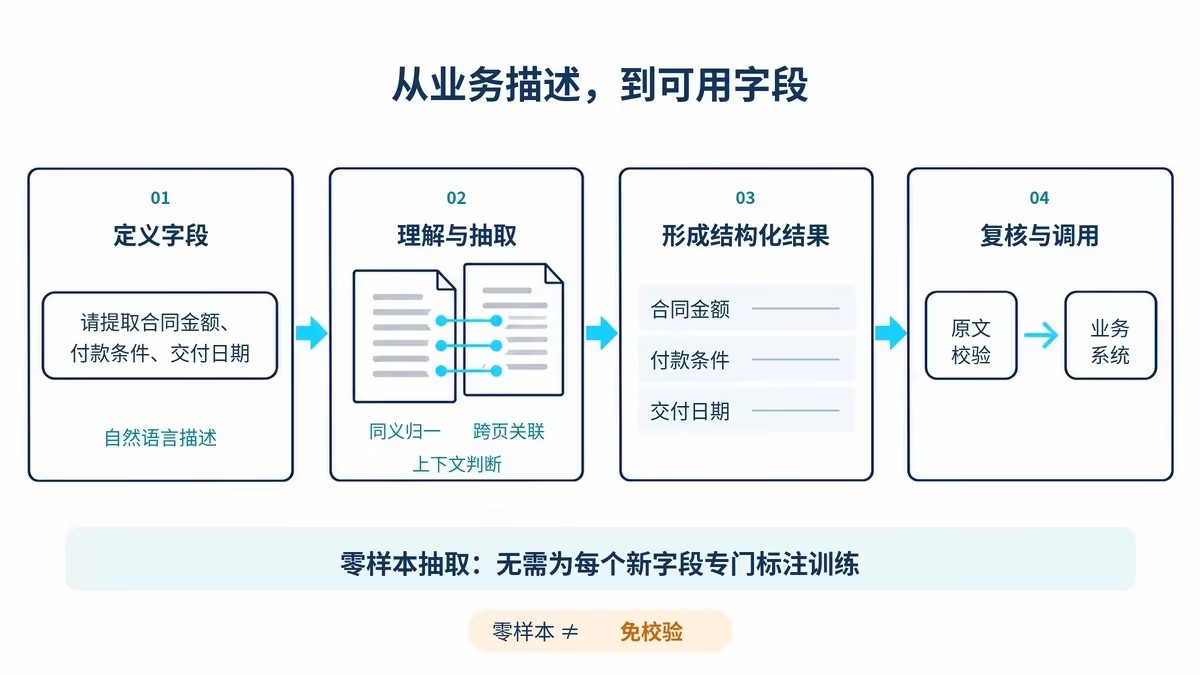
传统抽取项目通常走“标注、训练、上线、版式一变再重来”的循环;合合信息TextIn智能文档抽取支持零样本关键信息抽取,无需训练或标注,用户仅用自然语言描述所需字段,系统即可自动抽取。于是字段定义权从算法侧交还给业务侧,抽取能力也从一个个定制项目,沉淀为一套可复用的语义接入层。
在这套接入层里,大模型语义理解负责处理同义表述归一、跨页关联补全、隐含字段推理。单页非标卡证、票据、表单讲求快速定位字段,长合同则讲求章节理解与远距离关系补全。短文档考定位,长文档考关联,两者共用同一套字段语义体系,企业不必为不同材料重复建设抽取能力。
不过,字段被认识只是第一步。认识得对不对,还要能回原文查验;认识得全不全,还要能跨单据对账。
可被审计的抽取:坐标溯源与跨文档交叉审核
在实际业务中,企业场景不能接受“黑盒结果”。也就是说,字段抽出来了,还要回答两个问题:它从哪里来?它和别的文档是否一致?
合合信息TextIn智能文档抽取支持坐标溯源,抽取结果可高亮定位至原文坐标,方便人工校验。对财务、采购、风控等岗位来说,能够回到原文核对,结果才更容易被信任,也更容易纳入复核流程。
在跨文档场景中,合合信息TextIn还支持跨文档交叉审核。系统可以对合同、发票、入库单、物流单、付款凭证等多份材料进行整合与交叉验证,辅助判断金额是否一致、主体是否匹配、时间是否合理,从而支持自动化审单。
制造企业的采购到付款,智能文档抽取帮助企业数据“认识自己”
以制造企业的采购到付款流程为例。企业每天会收到大量复杂非结构化需求单、供应商合同、发票、物流单等业务文档。不同客户、不同供应商、不同业务系统的字段名称并不统一,交付时间、付款条件等信息可能分散不同材料里。如果字段不能被统一识别,后续流程就会反复依赖人工核对,比如采购要确认物料和数量,财务要核对金额和税额,仓储要确认入库信息,付款前还要再次校验合同、发票、物流和入库单是否一致。对此,可以引入合合信息智能文档抽取,先把物料名称、规格型号、数量、合同金额等关键信息结构化,再进入业务系统供人工复核和流程调用。
在这个场景中,智能文档抽取的价值不只是“把某个字段读出来”,而是让不同来源、不同格式、不同表述的信息进入同一套字段语义体系。字段一旦被认识,采购、财务、仓储和风控环节才能基于同一套可信数据协同。对制造企业来说,这既减少了重复录入和人工比对,也让后续异常发现、责任追溯和自动化审单有了基础。
应用时代,语义理解正在成为企业AI的重要竞争力
先让数据说清楚自己是谁、跟谁有关系,AI才谈得上智能。对企业而言,智能文档抽取不只是一个文档解析工具,更是连接非结构化数据结构化与业务流程自动化的关键一环。合合信息TextIn智能文档抽取通过零样本关键信息抽取、长文档理解、坐标溯源与跨文档交叉审核,为企业提供了一种更务实的路径:先把字段认识清楚,再谈智能应用。
点击下方图片,了解更多合合信息TextIn智能文档抽取的内容信息。