RAG效果提升别只换模型,表格识别筑牢知识库效果基线
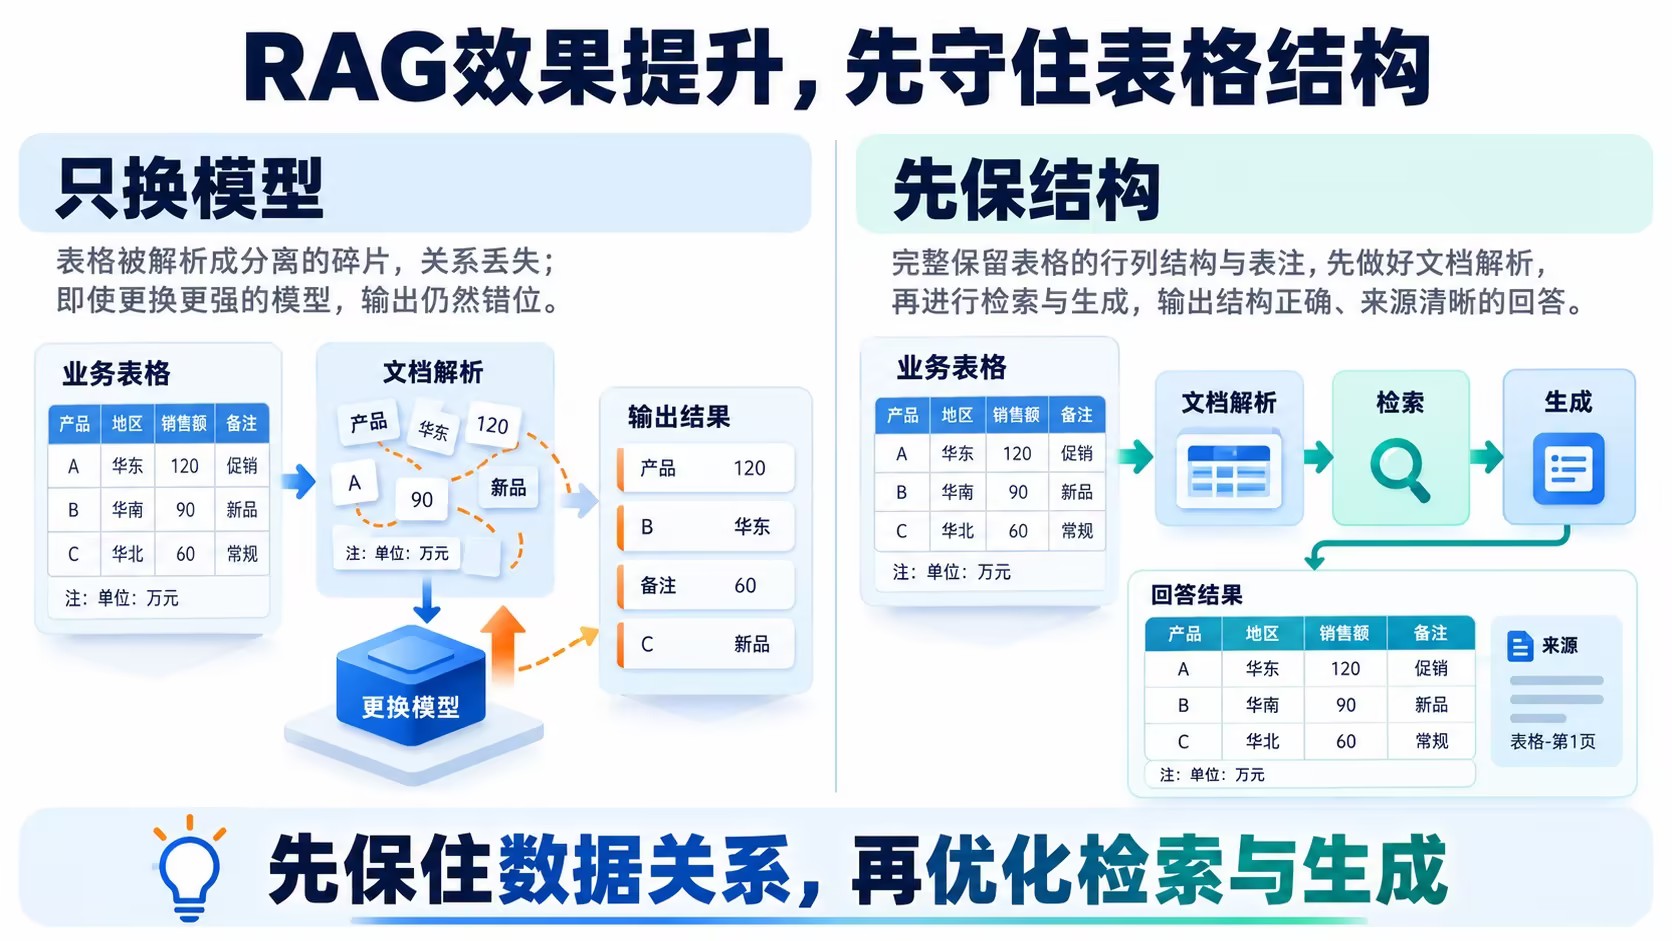
站在2026年回看,自2023年大语言模型开启规模化商用进程以来,生成式AI技术历经多轮迭代升级,企业级RAG知识库也同步完成了从POC概念验证到生产级规模化落地的行业普及,业内逐渐默认“效果不够就升级模型”,不少团队投入了可观的预算与研发资源,跟进大语言模型(LLM)参数迭代、切换更高精度的词向量(Embedding)服务、反复打磨文本切片策略,非结构化纯文本场景的问答效果已经得到充分验证。但当知识库开始接入承载企业核心经营数据的结构化业务文档时,效果往往会出现明显断层,持续在下游模型端加码,投入的边际收益十分有限。事实上这并非模型能力不足,而是很多落地项目都会忽略的上游盲区:文档解析阶段就已经出现表格结构断裂、语义关联丢失,相当于给模型递上了一盒打乱拼片、缺了边角的拼图,下游推理能力再强,也很难拼出准确完整的答案。
RAG知识库最常见的三类表格翻车场景
这种结构化数据场景的效果断层,具体到业务问答中会集中表现为三类典型表格故障,在制造、零售、金融等数据密集型行业的核心知识场景中最高发:
第一类是统计口径偏差。这类故障的典型表现是表格附属的统计规则、备注说明、口径注释与数值内容分离,大模型仅能读取裸数据,缺失完整计算逻辑,最终输出的汇总值、累计值存在系统性偏差。故障普遍出现在生产台账、经营快报、财务记账表等带补充说明的业务表格中,直接影响经营核算、产能统计等核心数据的可信度。
第二类是跨页内容错配。长表格受文档分页规则限制被截断为多个独立片段,检索阶段不仅容易只命中局部数据、造成结果缺项,还可能将不同维度甚至相邻表格的半截内容错误拼接,输出逻辑矛盾的结果。这类问题常见于年度财报、全量物料清单、全周期生产报表等跨页长表格,无法支撑供应链规划、年度经营复盘等全局性业务判断。
第三类是维度匹配混乱。带跨行、跨列的多级复合表头被拍平为普通文本行,数据单元格与维度标签的层级从属关系完全丢失,查询时极易出现区域、渠道、品类、时间等业务维度张冠李戴的问题。这类故障集中出现在分区域分渠道业绩表、多品类库存表、多周期业务统计表中,会直接导致分析结论完全失准,误导业务决策。
问题不在模型,入库时语义关系就已经断裂
针对RAG效果不达预期的问题,很多技术团队会把优化重心放在模型参数、切片策略上,但这类下游优化往往只能修正表述类问题,无法从根源解决表格数据错误的问题。
所以,企业在做RAG项目复盘时,可优先回查入库环节的结构保真度——绝大多数表格语义关联,在文档被解析成纯文本的那一刻就已经断裂,后续再强的检索、生成能力也补不回丢失的逻辑,这也是“模型越换越贵,效果提升有限”的核心原因。
从文档解析的技术链路看,三类核心断裂刚好对应前述故障:一是跨页表格断成多段,分页处的表格被识别为独立内容块,天然存在数据缺失;二是表头层级丢失,跨行跨列的复合表头被当成普通文本处理,维度标签和数据行的从属关系彻底混乱;三是表注与表格分离,表格和对应的计算规则、补充说明被拆分到不同切片,大模型拿到的只是零散数字,没有完整的上下文逻辑。
也就是说,即便单独用工具提取了表格内容,依然会出现数据与说明分家的问题——孤立提取表格只能拿到数字本身,无法保留表格和周边内容的从属关系。所以AI真正缺的从来不是存储,而是“关系”。就像如果读不懂管线与反应釜的连接关系,即便大模型参数再大也判断不了设备报警原因;如果拿到的是一堆被打散的零散数字,再强的生成能力也拼不出正确的表格答案。
表格往往承载了企业绝大多数高价值结构化数据,表格识别却又是文档解析中复杂度较高的环节之一,其精度影响RAG数据类问答的效果基线,也决定了整个企业知识库的数据质量。
全链路解析:还原表格完整结构的技术路径
针对这一行业痛点,合合信息TextIn xParse智能文档解析引擎,通过全链路版面还原与专项表格识别管线,从源头减少表格内容丢失与上下文断裂,筑牢RAG知识库的效果基线。
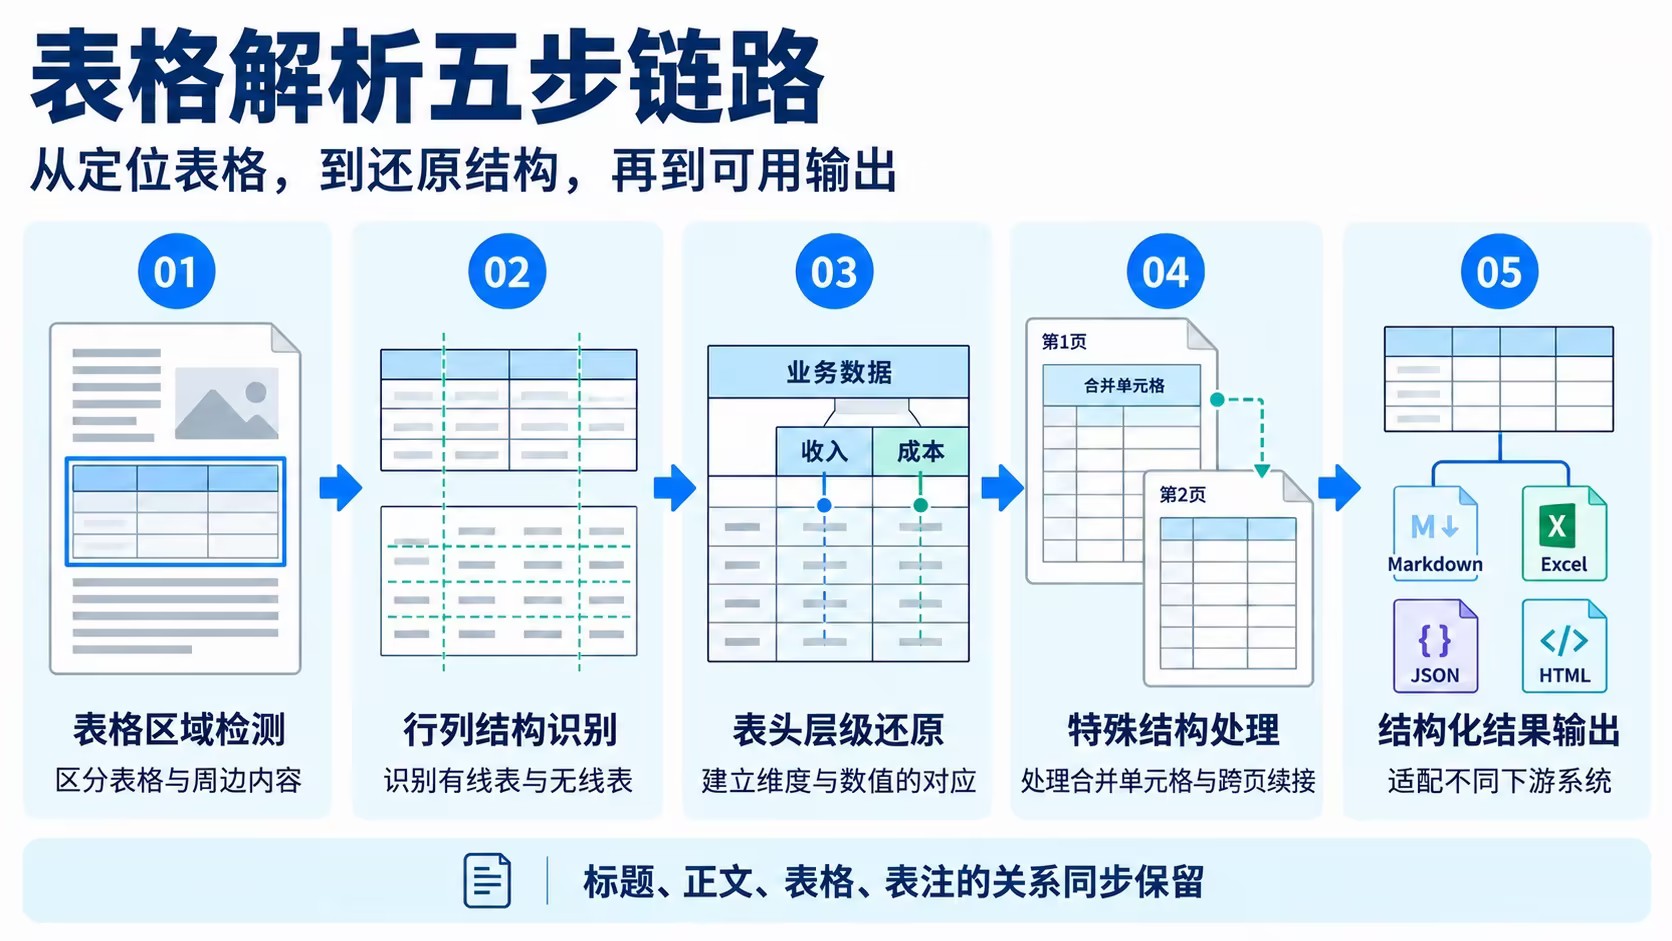
TextIn xParse覆盖「版面分析→元素分类→结构还原→多格式输出」全流程,可同步识别标题、正文、图片、公式、表格等全量文档元素并锚定从属关系;针对表格这类高价值强结构内容,专门设计了五步专项处理链路,从检测到输出全程守住结构关联:
第一步:表格区域检测。在图文混排的复杂版面中精准定位表格边界,把表格内容和周边的正文、图注、页眉页脚明确区分开,从源头避免内容混杂、错误拆分。
第二步:行列结构识别。不管是有明确边框线的有线表,还是靠空格、字符对齐排版的无线表、弱线表,都能准确识别每一行、每一列的边界,不会把同个单元格的内容拆成零散文本。
第三步:表头层级还原。识别跨行跨列的复合表头,保留多级表头的从属关系,让每一个数据单元格都能匹配到对应的维度标签。
第四步:特殊结构处理。对跨行、跨列的合并单元格做内容补全与关系映射;针对分页断开的长表格做跨页结构续接,拼接成完整统一的表格,减少跨页断裂和表头丢失问题。
第五步:结构化结果输出。适配不同业务场景的系统对接需求,输出多版本结构化结果。
这条链路可适配图片、PDF、扫描件等多来源载体,覆盖普通表格、跨页表格、多层表头、合并单元格、嵌套表格等多种复杂版式。性能表现上,TextIn xParse对常规印刷场景下的表格识别率超过99%,常规印刷文字识别率可达99.77%。
适配RAG入库,结构化输出无需二次清洗
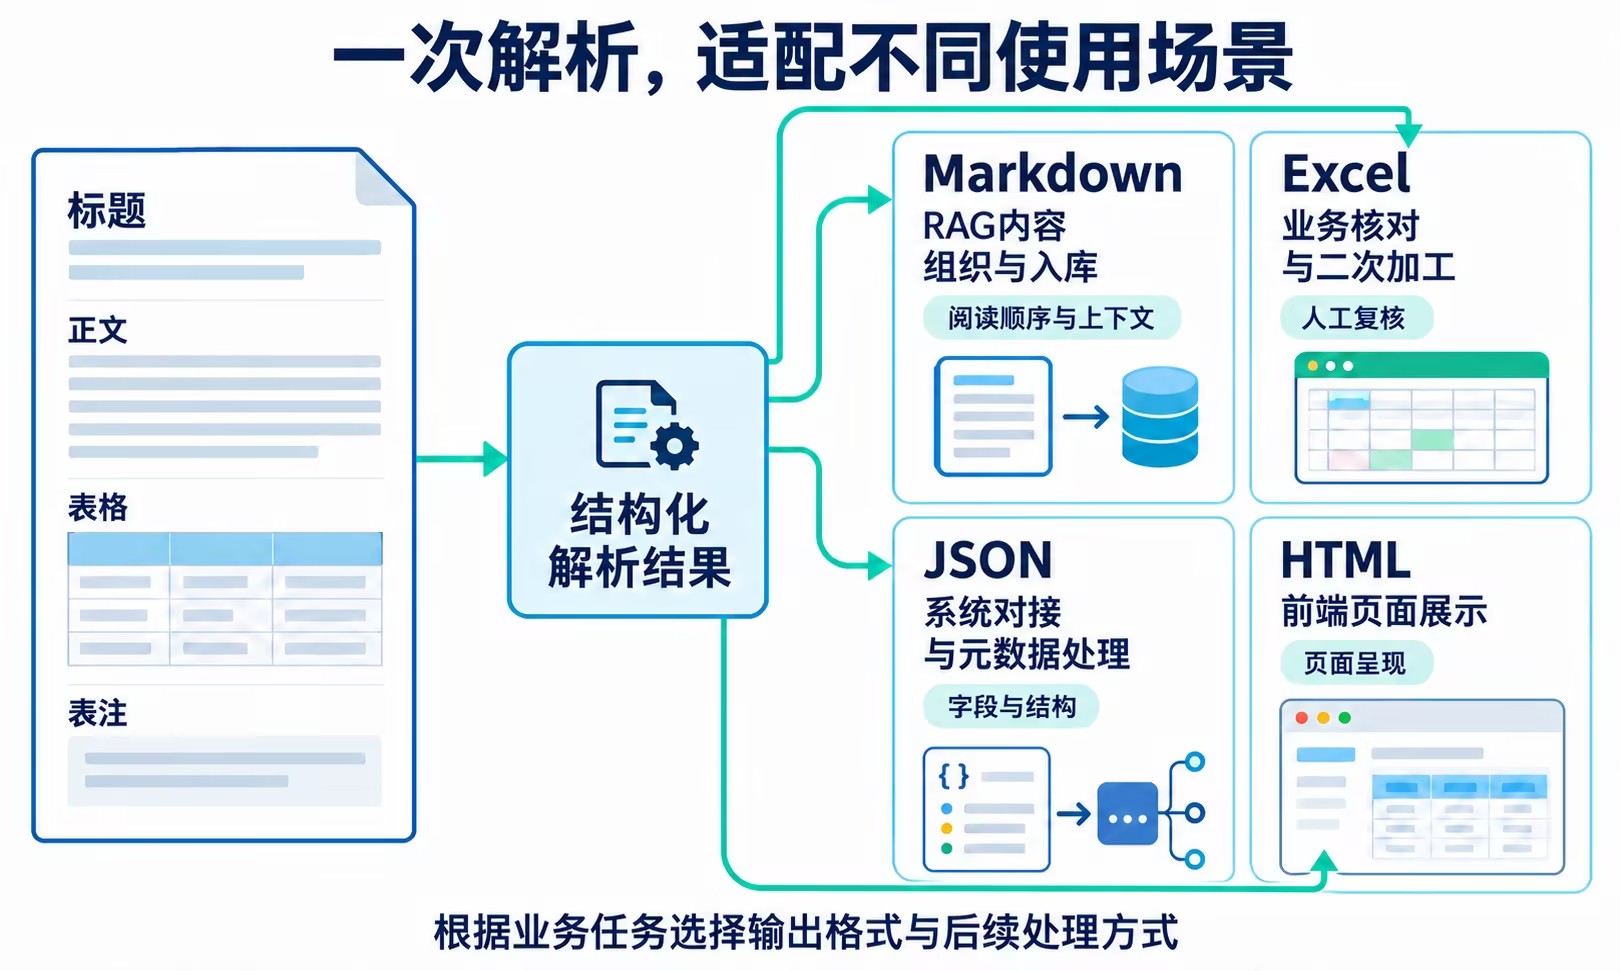
针对企业知识库搭建与RAG核心场景,TextIn xParse可直接输出全文档Markdown文件:其中表格内容会完整保留表头层级与行列结构,且严格按照原文阅读顺序,与表格标题、表注、补充说明、关联正文等内容排列在一起,无需人工拼接、代码清洗,可直接用于切片、词向量入库与大模型检索调用,真正减少表格内容丢失与上下文断裂。技术团队不用再编写额外脚本修正表格格式,也不用因为结构错乱反复调整切片规则,能大幅缩短RAG项目的落地周期。
如果有单独数据加工、内部系统对接的需求,TextIn xParse也支持将表格单独导出为Excel、JSON、HTML格式:Excel适配业务人员人工核对、数据二次加工;JSON附带完整结构化字段,方便AI中台做自定义元数据打标、切片策略开发;HTML则可适配前端页面直接嵌入展示。
单元格级坐标溯源,搭建质量校验闭环
实际业务中,企业知识库对数据准确性的要求远高于通用问答,尤其是涉及经营数据、生产参数的内容,每一条答案都需要可校验、可追溯。
TextIn xParse能够为所有文档元素返回原文页码、版面坐标等位置信息,针对表格还细化到单元格位置、字段位置,支持单元格级的原文溯源。入库质检环节,运营人员不需要逐页翻找原始文档对照,点击输出结果就能定位到对应表格的对应单元格,快速完成校验修正。这套定位溯源能力能为后续解析效果优化、错误样本沉淀提供基础,帮助企业持续迭代知识库的数据质量。
保住上下文,RAG才配谈智能
企业搭建RAG知识库,并不是堆砌大模型能力的军备竞赛,而是一场考验文档数字化精细度的基础工程。很多时候项目卡在落地阶段,不是因为大模型不够强,而是输入给模型的原材料本身就丢失了核心的语义关联。
复杂表格作为企业数据密度最高、关联逻辑最强的内容载体,是文档解析阶段必须守住的核心基线。高精度的文档解析能力能够把跨页断开的表接起来,把丢失的表头层级补回来,把分离的表注和内容归到一处,保住完整的上下文关系,后续的检索、生成环节才能真正发挥价值,输出准确、可信的问答结果。
地基打牢了,上层的智能应用才有稳定的发挥空间——保住上下文,RAG才能谈智能。点击下方图片,了解更多合合信息文档解析产品TextIn xParse的更多内容信息。