医药大模型语料:解析质量决定知识库能不能用
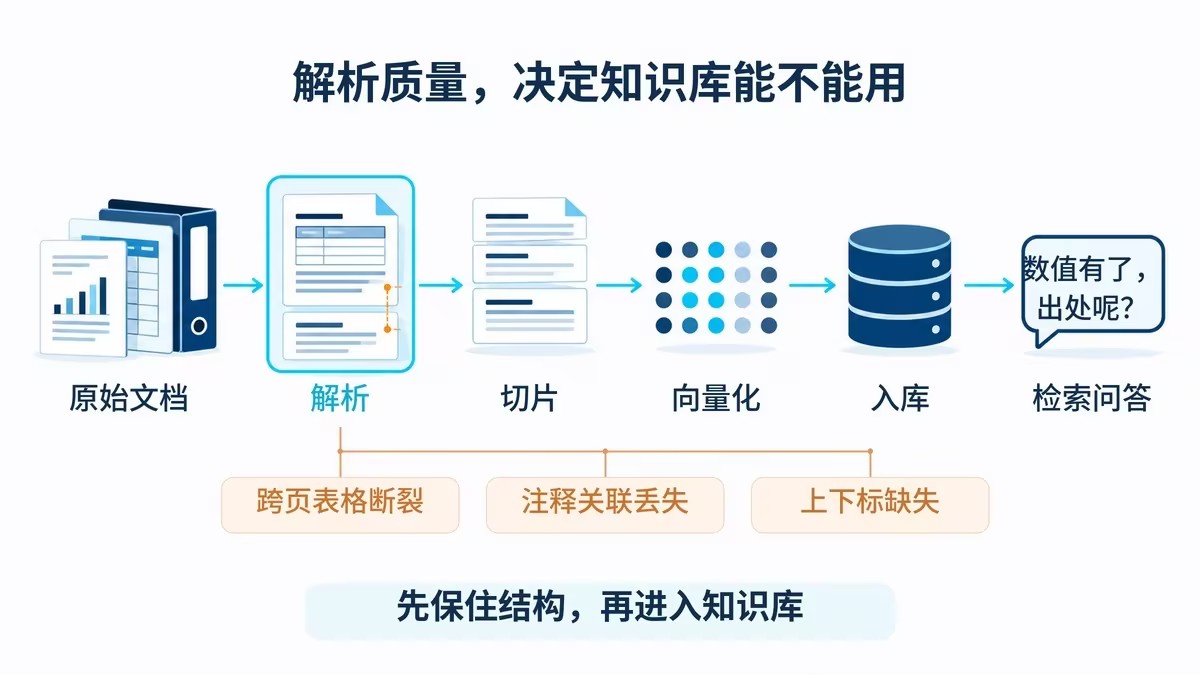
医药企业准备医药大模型语料,路径往往是固定的:解析、切片、向量化、入库,最后由检索把片段交给生成。其中,断点常出现在第一步——研发报告、质量标准、说明书与 SOP 这类药学文档,关键数值多数不在正文段落里,而在跨页附表、图注、脚注与多栏版式中,另有相当一部分以分子式与上下标的形态存在。解析只取出文字,这些内容就整块缺席;导致后续按字符切分、按段落建索引等流程也无法覆盖全部数据。等到问答阶段时,发现某处数值答不上出处,而此时库里已经有大量数据,返工抑或是重新搭建,成本都不低。
药学文档的难点不在文字,在它存放信息的方式
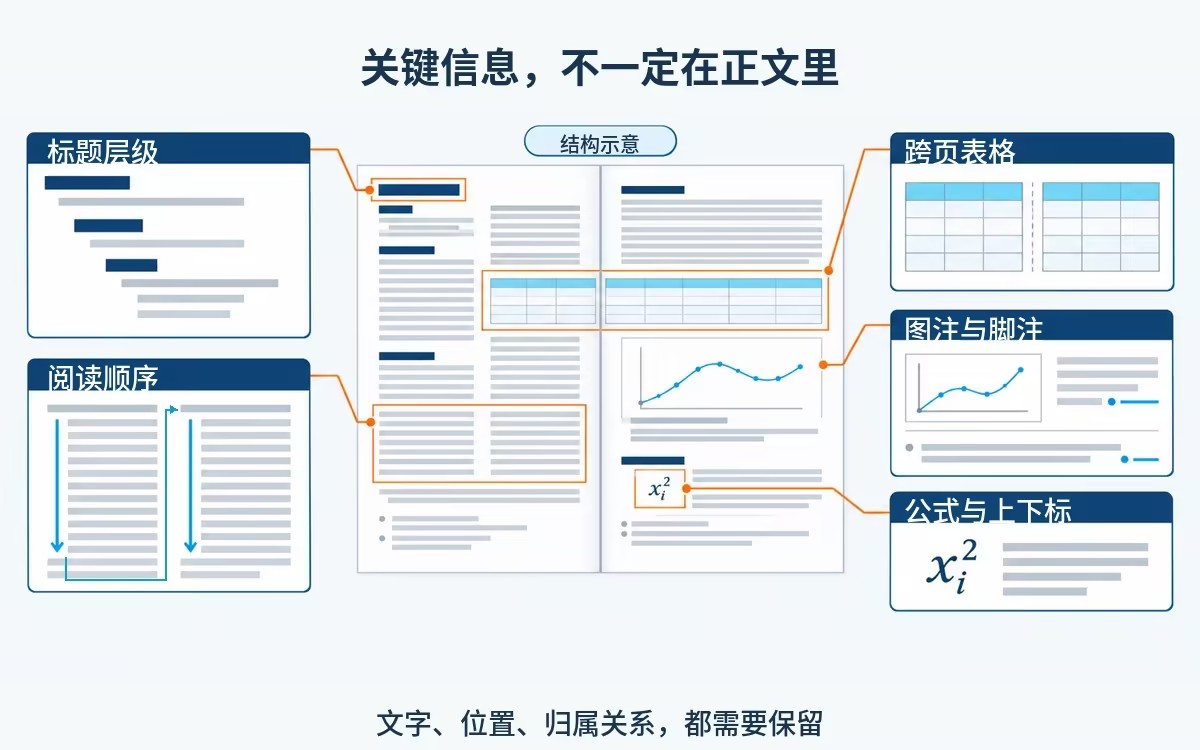
搭建医药大模型语料,难点不只在字难认,更在于信息可能不在句子里。比如,关键数值多数写在附表中,一个表跨三页并不罕见;图表混排与多栏排版,让阅读顺序不同于物理顺序;上下标之差指向的是不同物质,而这层差别只存在于版面。这类文档为人的阅读而排版,层级、表格与注释的位置本身承载含义——图注属于哪张图、脚注指向哪张表、这一段隶属于哪一级标题,都不写在正文里。位置与归属不是文档自带的属性,它要在解析环节重新建立。
一处解析偏差,沿着链路往下放大
前述问题还会传导并影响到后续链路。比如,若标题层级没有还原,切片只能按字符窗口截断,一张跨页附表被切成互不相邻的两段,各自得到一个向量,检索召回的就总是半张表;表格结构没有还原,同一行的限度值与方法列不再对应,取出的数值张冠李戴;上下标没有保留,分子式指向的就是另一种化合物。这些偏差入库后不再显形,它们藏在回答的形态里:答得上来的只是一部分,给出的数值指不到出处。事后纠正,得先判定整批资料的版本,再把解析与入库重跑一遍,成本按整批计,而不是按出错的那几处。
合合信息TextIn xParse:把文档内部断掉的关系补回来
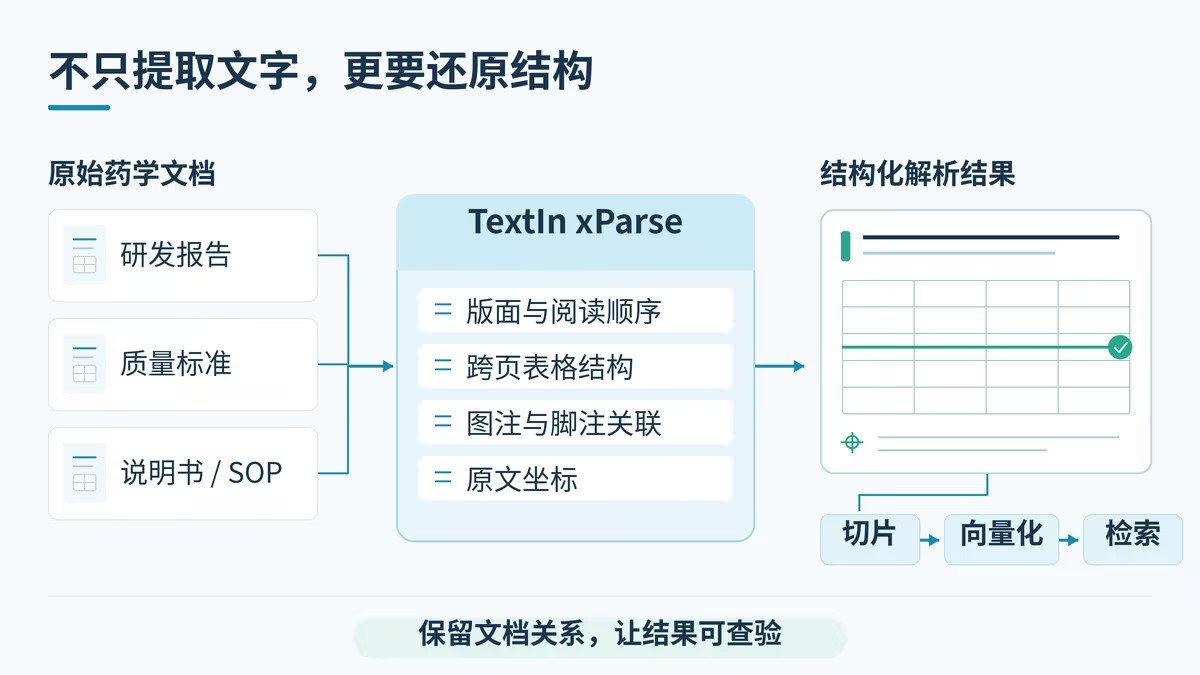
上述偏差缺失的是文字之间的关系——标题与段落的、表格与页面的、注释与所指对象的。合合信息文档解析产品 TextIn xParse 做的不只是把 PDF 变成文本,而是把文档内部断掉的关系补回来,这也是它作为 AI Infra 组件的原因:上层是切片、向量与检索,下层是一摞格式各异的原始文件,它交付的是前者能直接使用的内容。复杂版面上,xParse能将双栏与三栏的段落按正确阅读顺序还原,标题、段落、公式、印章、图表等 16 类以上版面元素被准确识别;跨页断开的表格恢复连续结构,多级表头与合并单元格回归原本的层级;图注、脚注与所指对象的关系一并输出。其输出的解析结果带原文坐标,机器读到什么,人可以进行对应查验。性能上,100 页长文档最快 1.5 秒完成解析,离线批量三天可完成 500 万页,综合还原度 95%,表格识别准确率 99%,服务可用性 99.999%,覆盖 52 种以上语言,输出兼容 LangChain、Dify、Coze 等框架。
自建解析链路通常停在哪一步?xParse助力团队落地全流程
多数医药团队准备大模型语料的第一步,往往是先用开源组件把链路搭起来。但是开源方案完成的是文字识别这一步,即把字符读出来,而层级、表格边界与分子式不在交付范围内——这几项也正是偏差的来源。某大型药业集团在建设统一 AI 平台时,自研工具先在复杂表格、长图文字与医学专业文档上停住,输出无法直接进入知识库,人工预处理成为必经环节。对此,该集团引入了合合信息TextIn xParse 作为解析引擎,人工预处理减少 80%,日均支撑数千单审核预处理,并以高可用部署横向扩容,沉淀为集团级服务。
医药大模型语料的验收口径
对于正在建设医药大模型语料的团队来说,建设流程可以先窄后宽:先选一类文档,比如质量标准或药品说明书,对解析口径、切片规则与入库流程进行测试,再扩到其他类别与语种。关于验收口径,团队不应只看入库多少页,更应当看包含重要数据信息的跨页表格、含分子式的资料与扫描件等能否跑通测试,还应看答案给出的每一条数值能否指出来源。
点击下方图片,了解合合信息文档解析产品TextIn xParse 的内容信息。