企业AI中台建设方案:先把数据层的文档解析能力做扎实
不少企业的 AI 中台建设会遇到相似的卡点:算力到位了、模型已接入、平台也上线了,但合同、财报、设备手册等业务文档喂不进去,最后的结果是知识库答不准,应用也没办法落地。而出现这种问题,原因通常不一定在于模型能力,而在数据层的文档解析能力——这也是企业AI中台建设方案中容易被忽视的一环。
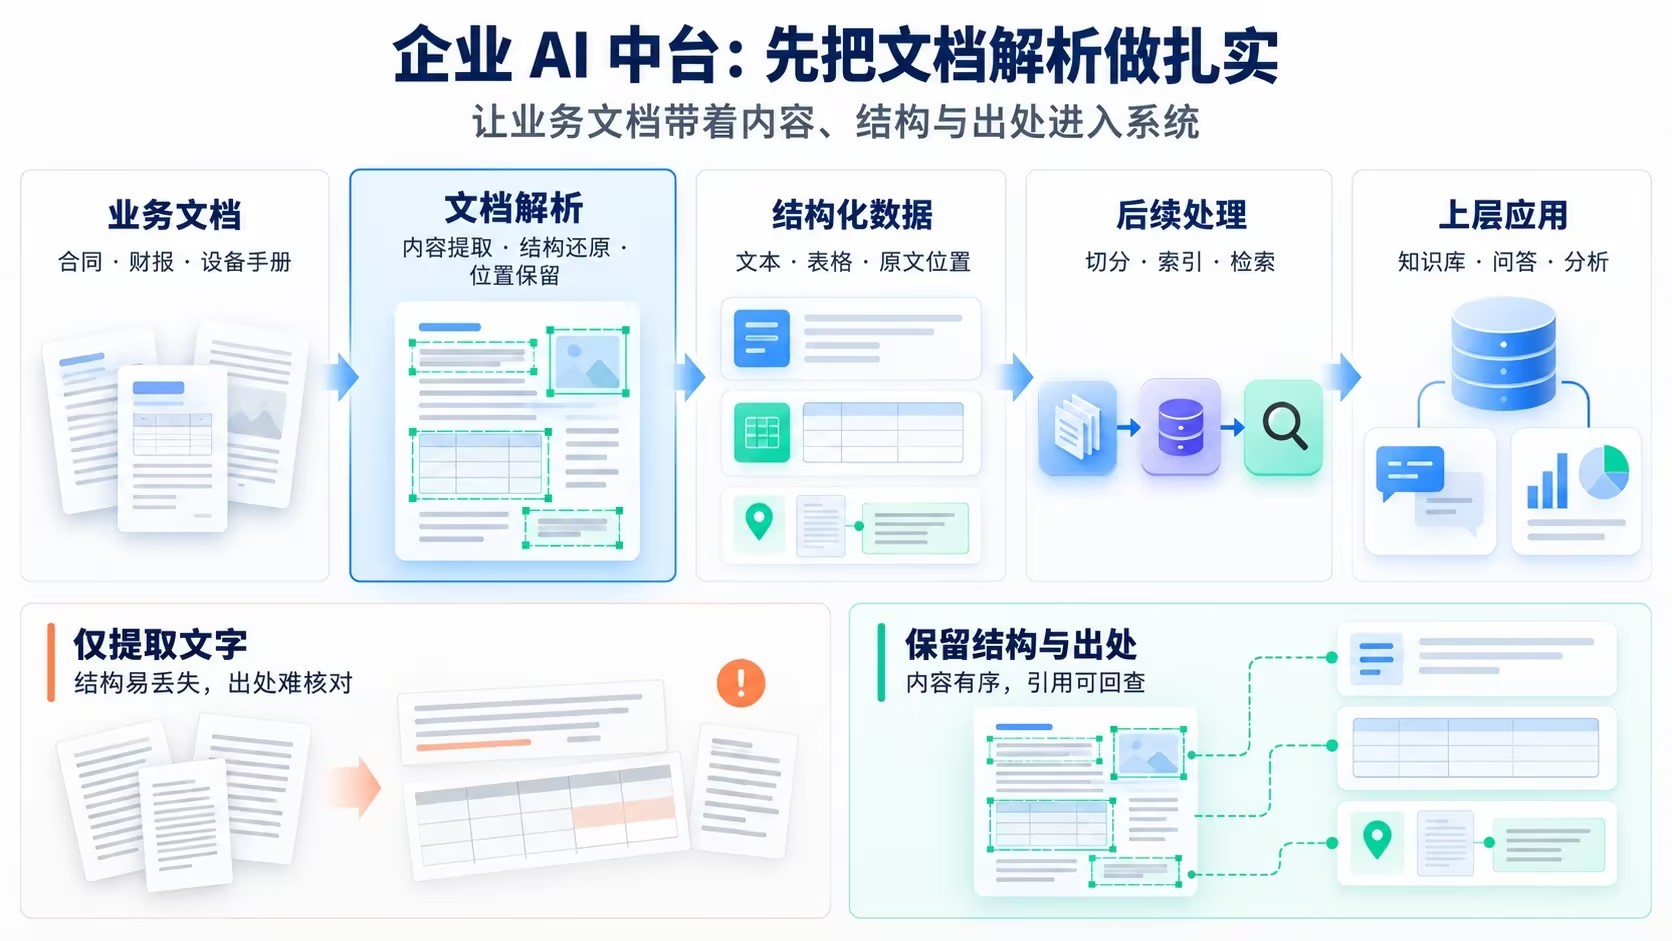
文档解析是数据层的基础工序,不是外围工具
在进行 AI 中台建设立项和评审时,企业往往将预算和注意力集中在算力采购、模型选型和平台功能上,文档解析很多时候被当作“数据接入的一个小工具”排到最后。等到应用上线,诸多问题才暴露,比如,供应商资质文件是图片型 PDF,系统读不出内容;信贷合同的关键条款嵌在扫描页里,由于结构复杂,检索时整段丢失;又或是报表数据进了知识库,却查不到出自哪一页。这些问题的共同根源是,文档入库时只被当作字符流处理,版面结构和出处信息在一开始就被丢掉了,换句话说,就是复杂文档的解析没有做好。在AI中台建设中,这项过程通常会被忽视,但其实在 AI Infra中,它是数据层重要的一环,决定了业务文档以什么状态进入中台,进而决定上层应用的效果上限。
企业文档解析落地:选型抓住路径、维度、验收三件事
明确了文档解析这项能力的重要性,那么对于企业团队,能从哪里获得这项能力?其实,补齐文档解析能力并不需要复杂的流程,抓住三件事就够了——选对路径、定准标准、做好验收。
先选路径。不同路径有各自需要考虑的因素:开源自建单价低,但复杂版式调优、批量处理和权限管理都要自行投入,摊到一年往往是几个人力月;完全自研可控性最高,但团队成本也最高,除非文档处理本身是核心业务,否则回报周期很难算平;而采购企业级服务,是用采购成本替代研发投入,把效果责任转移给服务商。
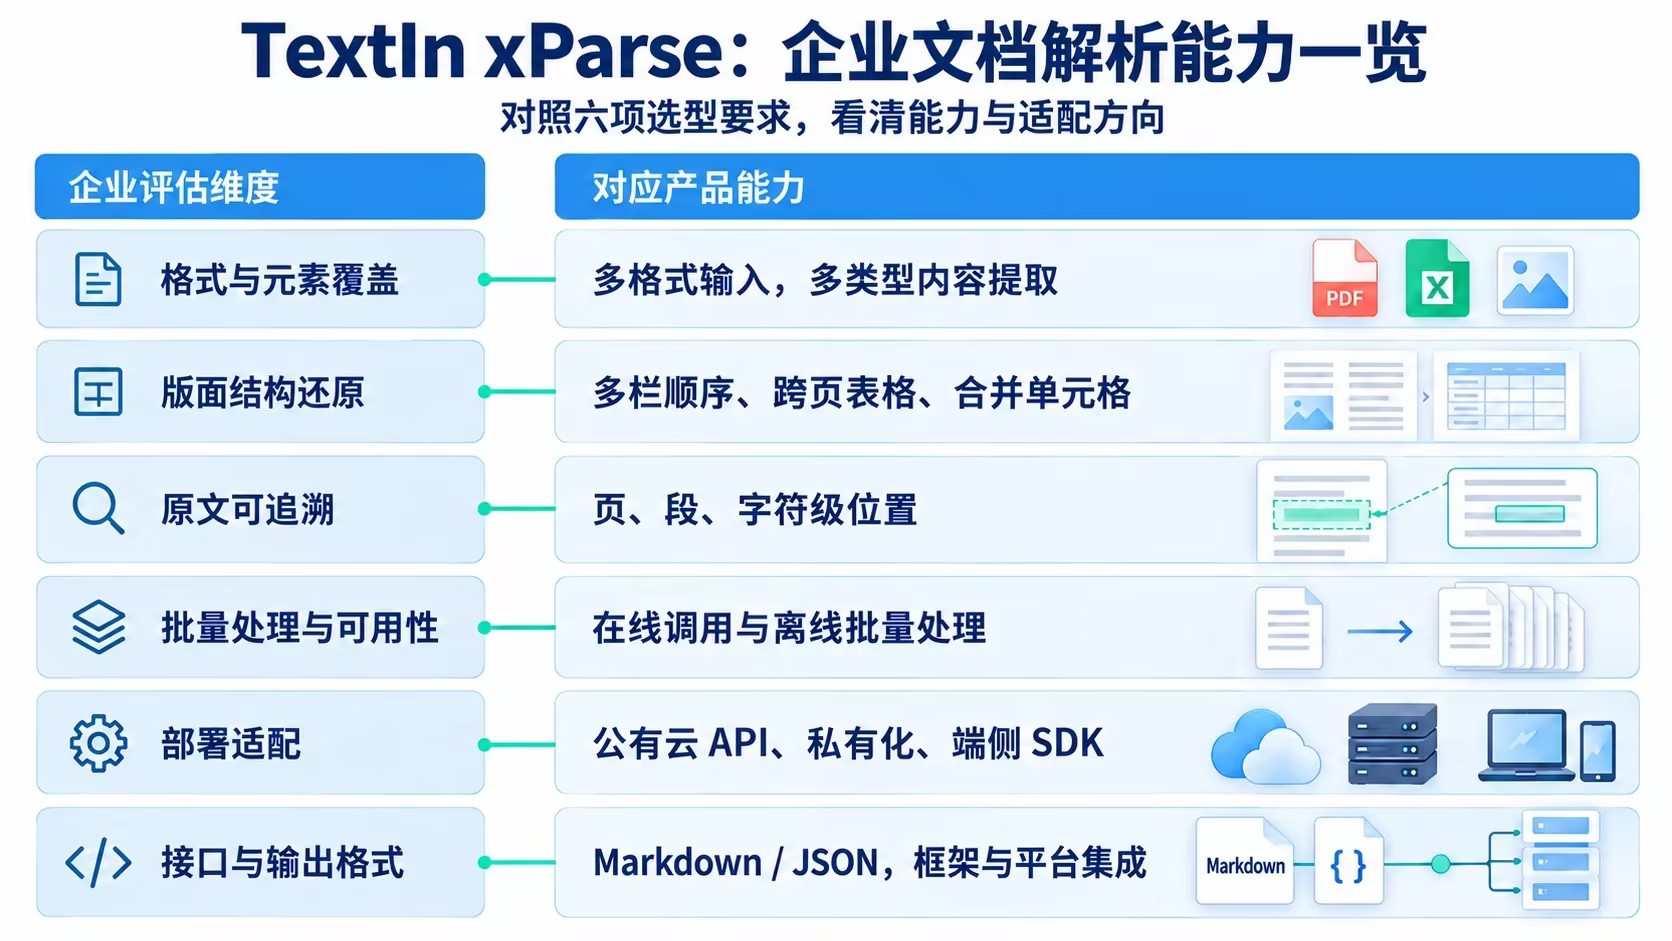
再定标准。无论走哪条路径,企业团队都可以用六个维度评估:
数据格式与元素的覆盖;
版面结构的还原,如多栏阅读顺序、跨页表格的行列对应;
原文可溯源,即页、段、字符级位置;
批量与承载,比如速度上限与可用性承诺;
部署方式,如私有化与信创需提前核实;
集成成本,企业团队需查看输出格式与接口是否通用。
最后用真实文档验收。业务团队抽 50 份有代表性的真实业务文档跑一遍完整流程,检查内容有没有漏、结构有没有乱、出处能不能查,验收标准事先书面约定。
合合信息 xParse:从内容提取到部署集成的完整解析能力
对于上述六个维度,合合信息通用文档解析产品 TextIn xParse 的能力可以逐项对照。xParse 是面向大模型、RAG 与 Agent 应用的通用文档解析引擎,企业可以通过 API 或 SDK 调用,将复杂文档解析为结构化数据,为知识库、问答、分析等上层应用提供数据基础。
在内容提取上,xParse 支持 PDF、Word、Excel、图片等 50 余种文档格式,可识别文本、表格、公式、印章、手写体等 16 种版面元素,覆盖 52 种语言,解析结果能够以结构化的 Markdown 或 JSON 格式输出,便于直接入库或对接业务系统。在结构还原上,xParse支持双栏、三栏阅读顺序还原,以及跨页表格与合并单元格处理,覆盖有线表、无线表、少线表、跨页长表等情形;同时提供页、段、字符级的元素位置信息,下游应用可据此建立解析结果与原文之间的对应关系,让检索和引用可以核对出处。
在识别精度上,xParse 对于常规印刷文字的识别率达 99.77%,表格识别率超过 99%,复杂文档综合还原度达 95%。在处理能力与稳定性上,xParse对于100 页 PDF 的在线解析快至 1.5 秒,离线自动批量解析可 3 天解析 500 万页 PDF,日均支撑数百万次调用,服务可用性达 99.999%。
在部署与集成上,xParse 提供公有云 API、私有化部署与端侧离线 SDK 等方式,私有化环境支持国产信创设备;并已接入 LangChain、Dify、MCP Server、RAGFlow 等主流开发框架与平台,可以快速融入企业现有 AI 中台架构。
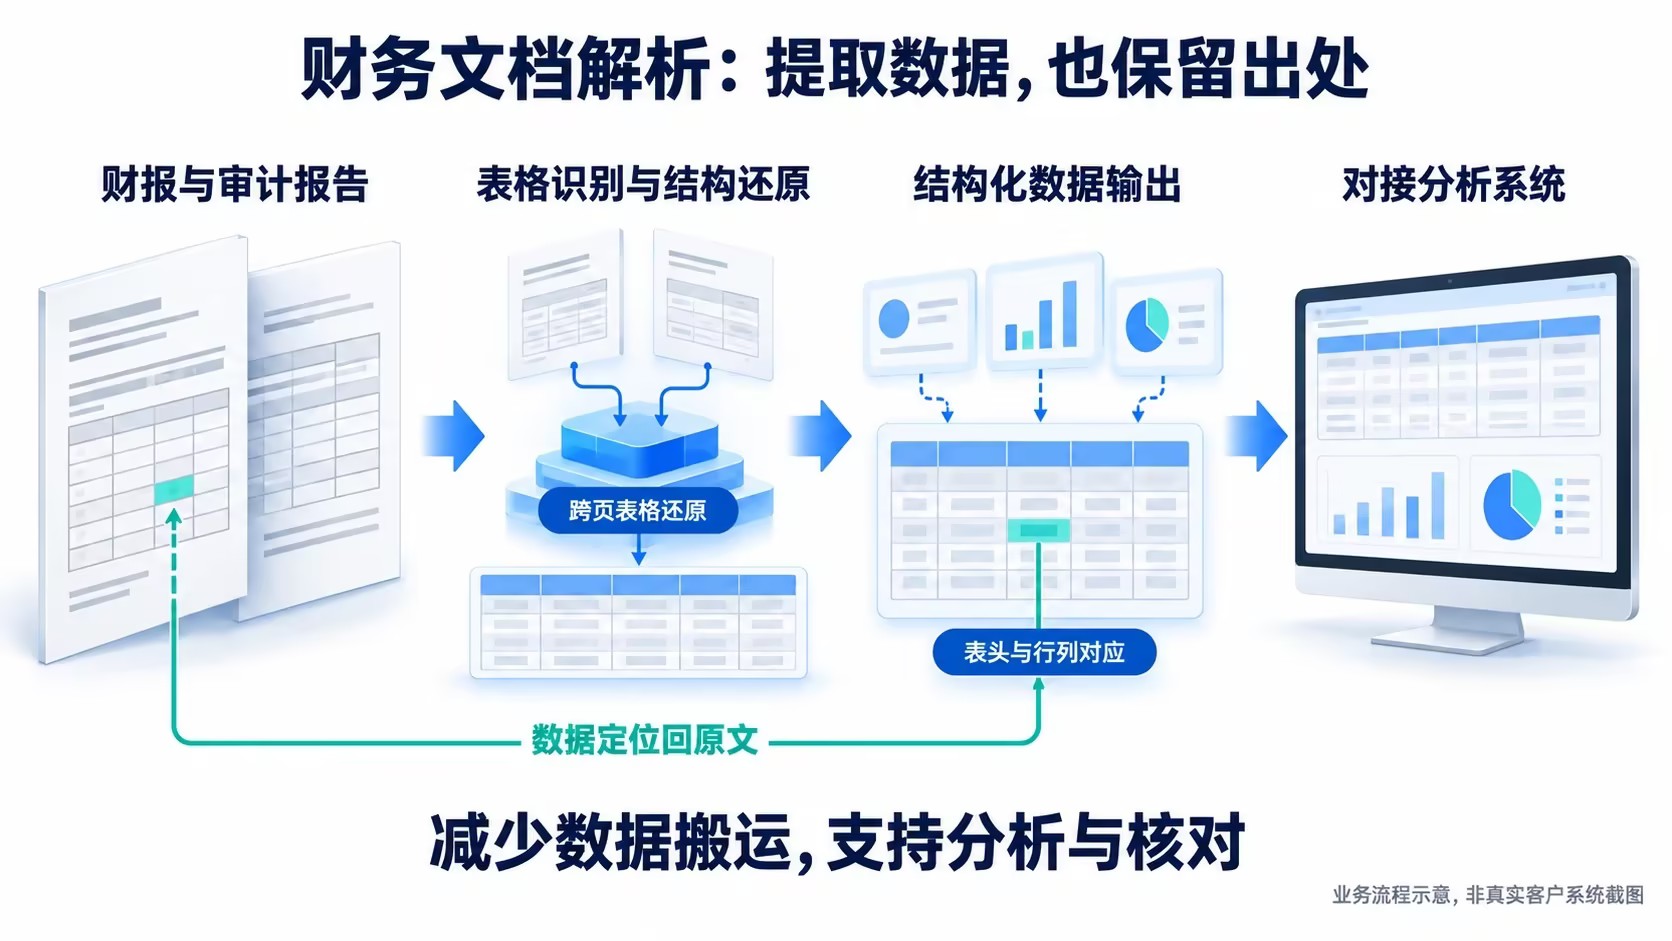
xParse帮助企业财务团队实现从人工整理到自动识别录入
以企业财务分析业务为例。财务团队每季度要处理大量 PDF 格式的财报和审计报告,其中关键财务数据大量存在于跨页表格和附注中。如果依靠人工整理,不仅耗时,还容易在誊录环节引入错位,进而影响后续分析结论。针对这个场景,可以接入合合信息通用文档解析产品 TextIn xParse,从而实现系统自动识别财报中的表格内容,还原跨页表格表头与行列数据的对应关系,并输出结构化结果,直接对接分析系统调用,省去人工录入和表格重排环节。同时,每项数据都能定位回原文页和段落,分析人员引用数据时可随时核对出处。引入xParse文档解析产品,实现财务数据的准确提取,让团队把时间花在分析判断上,而不是数据搬运上。
文档解析这道工序,值得先做扎实
对于企业的 AI 中台建设,文档解析可能不是预算最大的环节,却往往是影响上层应用效果最直接的环节。如果企业正在排查知识库和应用效果不佳的原因,可以把数据层作为优先检查项;如果已经明确要补齐这一能力,不妨先用真实业务文档做一轮验证,再依据结果决定自建还是采购。需要成熟的企业级能力时,可以通过接入合合信息通用文档解析产品 xParse,将复杂非结构化文档处理成结构化数据的工序,交给经过大规模业务验证的解析引擎。企业AI中台建设方案的成败,很大程度上就取决于数据层的地基是否扎实。
点击下方图片,了解更多合合信息通用文档解析产品的内容信息。