企业文档解析选型:从识别精度到业务落地,关键看什么?
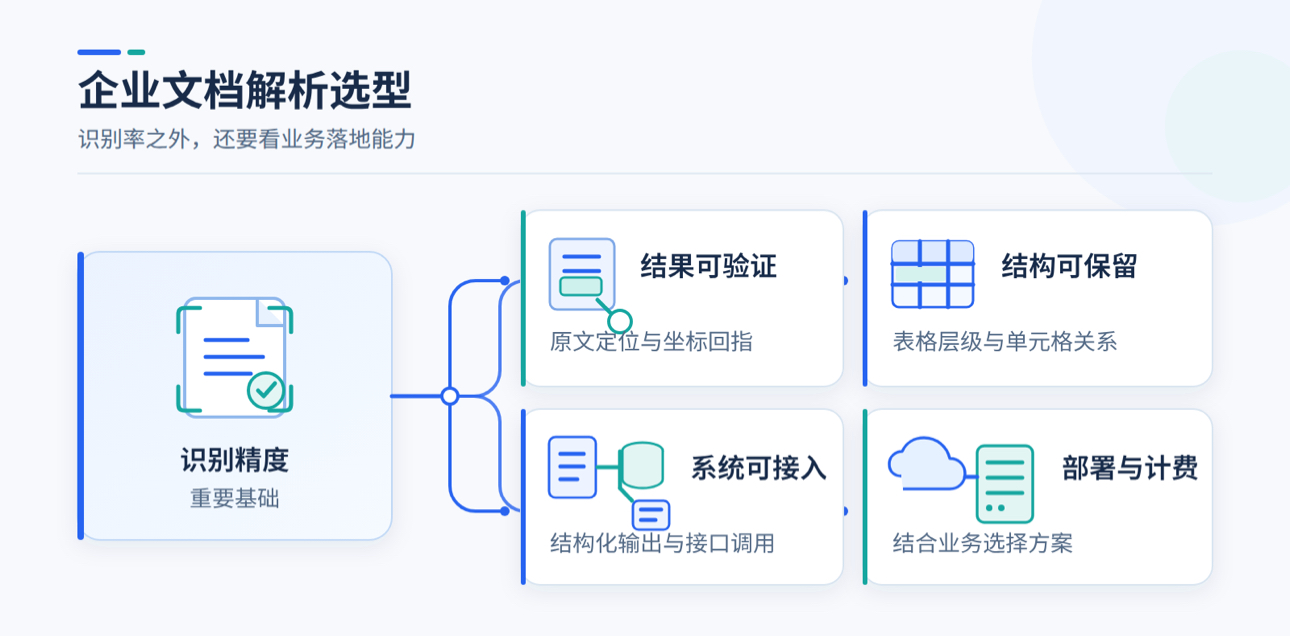
当下,文档解析选型,难点往往出现在识别率已经够用之后。在概念验证阶段,结果往往看起来都不错;然而上线后,如果一个字段找不到出处,业务人员仍要翻页核对。所以,文档解析选型应当在识别率等性能参数之上,把可验证性纳入核心评价,从企业实际业务出发,从“识别了多少”进一步走向“结果如何确认”。
人工复核成本不容忽视,文档解析选型不能只看识别率
在企业实际业务场景中,文字有没有认对、字段有没有对应正确、业务人员能不能验证,它们并非同一件事。例如,检测报告里的数值识别正确,却可能关联到了另一个检测项目;或者数值和项目均正确,但遗漏了表头中的单位。字符层面的正确,不能直接替代字段关系的正确。复杂表格尤其如此,数值含义还依赖行名、表头层级和上下文。
因此,对于文档解析选型的讨论,应把识别率等作为重要的参考数据,但这不是某份业务文件可以免检的依据,而应该继续追问:输出一个字段后,是否同时保留了足以确认它的原文证据?
这也是文档解析服务容易被低估的一项成本:人工不仅在核对,还需要寻找核对对象。合合信息TextIn xParse 的坐标输出,正是为原文对照与人工校验提供支持。如此,才能减少复核之前的查找动作,让文档解析选型与实际业务效率建立联系。
字段能够回到原文,而不只是返回一个页码
合合信息TextIn xParse 将可验证性落实在页面、段落、字符等定位层级。页面定位回答“在哪一页”,段落定位缩小到具体内容区域,字符级定位进一步支持细粒度对照。对于同页出现多个相同名称或数值的文档,这种分层定位比仅返回页码提供了更明确的核对入口。
在解析结果上, xParse支持将PDF、Word、Excel、图片等复杂文档解析为Markdown、JSON,提供结构化输出。结果中的边界框用于描述内容在页面中的位置。结合原始文件,业务系统可以将结果与原文区域关联。文档抽取接口还支持输出抽取结果的精确坐标,为字段回指原文提供依据。
落实到接入路径,企业通过 API 或 SDK 获取解析结果,再由业务界面呈现“字段、来源页、原文区域”的联动关系。xParse能够使用块级与字符级坐标进行原文对照,为实现高亮核验提供基础。
表格中的复杂数据结构关系,如何保留?
原因在于,“数字在哪里”与“数字是什么意思”是两个问题。一张表中的“合格”,可能对应不同检测项目;仅圈出数值,仍不足以证明字段关联正确,数据的结构关系被准确还原。所以,文档解析选型不能止于文字定位,还应理解结构关系如何进入结果。
合合信息TextIn xParse 可同时输出表格树与单元格几何属性,前者能够承载表格层级和组织关系,后者提供单元格的位置依据。其复杂表格解析能力还支持多层表头、合并单元格和跨页表格等结构,并保留字段对应关系与上下文。这使文档解析服务不仅提供散落的文字,还为下游恢复字段语义提供结构基础。
复杂元素、不同语种等业务卡点,如何高效解决?
xParse 支持16类以上内容元素、52种以上语言,元素范围包括文本、表格、图片、标题、段落、列表、公式、印章、手写体、页眉页脚、脚注等。对文档解析服务而言,这些能力的意义不只是扩大可处理内容的范围,更在于为区分正文、表格、注释与其他内容提供基础。
前文提到,xParse 支持结构化输出,所以,其解析结果可作为检索增强生成,也就是 RAG、知识库和业务系统的数据输入,还提供结果回溯与可视化能力,知识库可据此建立答案与原始内容的关联。企业团队在接入时,可以同时保存文档标识、页码和坐标,避免出现“在文档解析选型时重视溯源,进入知识库后却只剩一段没有出处的文本”等诸如此类的问题,便于业务提效。
合合信息TextIn xParse:多种部署方式,灵活计费
合合信息TextIn xParse的文档解析服务日均支撑数百万级调用,调用成功率可达 99.999%。文档解析选型时,应当把内容质量与服务稳定性分开理解,内容质量关系到结果是否正确,后者则关系到处理流程能否持续运行。
在使用形态上,按产品方案可提供云端 API、SDK、私有化、私有云、端侧 SDK 与 Web 入口,具体功能范围与交付条件应以对应方案为准。官网同时提供在线调用、在线预览与导出、离线处理和私有化部署等接入方式。
费用上,云端文档解析服务可按调用使用量计费,具体套餐涉及按页核算;私有化部署则有不同付费机制。文档解析选型的经济性,应当包含人工复核与返工成本,而不是仅比较接口价格。坐标溯源的价值,最终要在这些业务工时中体现。
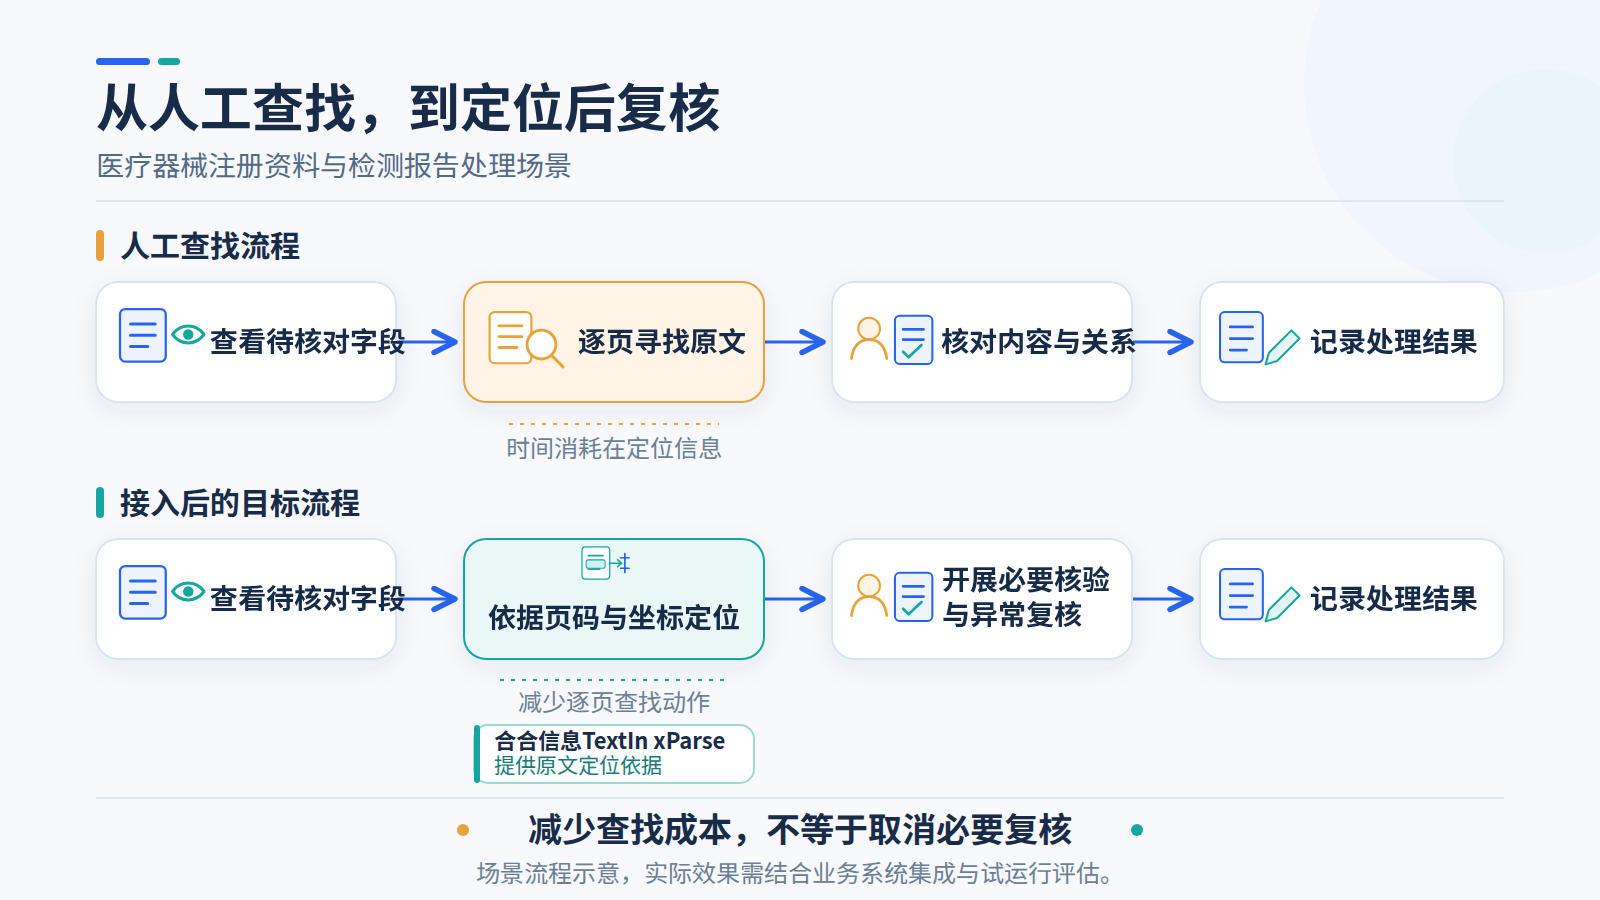
xParse帮助企业从“人工查找”到“自动定位再复核”
以某医疗器械企业的注册资料与检测报告处理场景为例。原流程需要人工逐字段核对产品型号、检测项目和结果,发现疑问后再回到文件中翻页寻找依据。针对这一场景,可以接入合合信息TextIn xParse ,它能利用页码、字符定位和单元格位置,将待核验字段关联到原文区域。业务人员便可以按坐标抽检,把更多精力放在对异常项和必要字段执行相应复核上,而不用先逐页寻找核对对象,实现效率的提升。
识别率之后,文档解析选型应落到什么结果?
识别率仍然重要,但它不是文档解析选型的终点。合合信息TextIn xParse 通过原文定位、保留表格结构和结构化输出,为结果确认与下游使用提供基础。相较于继续放大一个精度数字,更有业务价值的问题是:字段能否对回原文,关系能否解释清楚,接入方式是否便利企业。
当文档解析服务输出的不只是内容,还有可用于确认内容的来源依据等,文档解析选型才更容易从参数比较走向流程改进。对企业而言,这也是衡量自动化收益更具体的起点。
点击下方图片,了解更多合合信息文档解析产品内容。