企业如何让 AI 大模型读准合同与年报?前置的文档解析很重要
AI 读取 PDF 准确吗?把合同、年报直接交给大模型,企业真正需要的不是一段通顺的回答,而是能核对、能入库的正确字段。这里就出现了问题:能读,不等于读得准。语义理解虽然是大模型的强项,但大模型并不负责在输入环节保住文件数据的版式关系。也就是说,当大模型进行分析时,文件中的行列与表头很可能已经被压平,那么它所分析的数据已经是乱码错位后的。最终后果是,在它流畅的表达背后,很可能藏着错误。所以,企业需要的不只是更强的模型进行数据结果的分析,还需要一项重要的前置能力——专门把非结构化文档转成结构化数据的能力,如此,才能让 AI 对PDF 的读取和分析更可靠、可溯源、可验收。
回答看似有理有据,背后字段仍可能错行
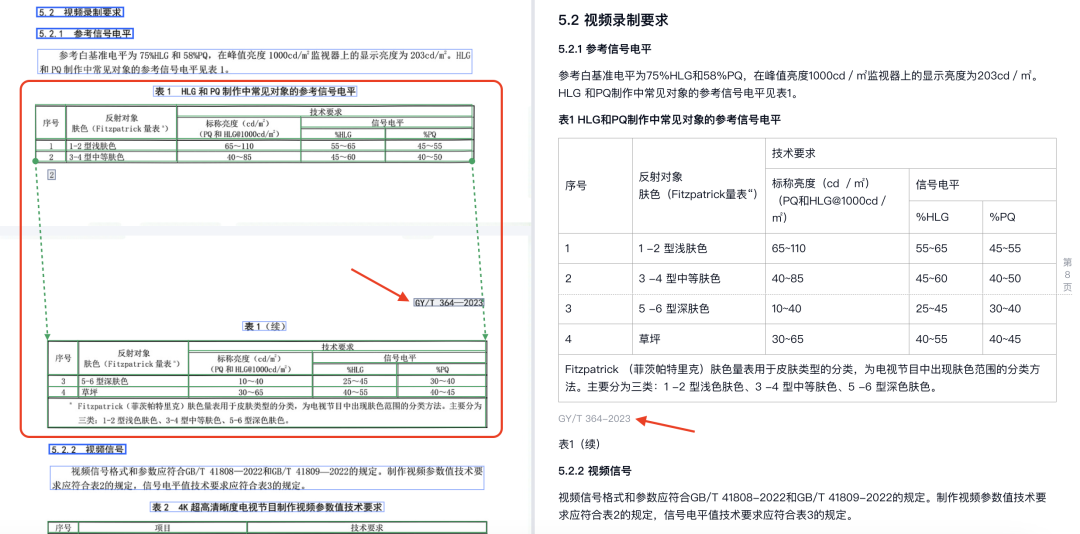
前文提到,大模型不负责在输入环节保住文件数据的版式关系,换句话说,这是结构丢失造成的风险,不只是文字识别问题。举个例子,设想一份采购合同:附件报价表跨了两页,第一页标明“含税单价”,第二页继续列出物料;正文是双栏排版,付款条件旁边还有补充说明。如果文档解析只做到抽出文字、按行拼接,表头与数据可能分离,左右两栏也可能交错。此时即使每个数字都识别正确,数字属于哪个物料、采用什么单位,仍可能对应错误,后续分析的可靠性也难以保证。
为什么文档解析值得单独建设?在“先用文本抽取把 PDF 转成文字、再交给纯文本大模型”这条常见链路里,模型接收到的大多已经是摊平后的线性文本,原本依靠空间位置表达的行列关系、表头层级和跨页关联被削弱了。那么,大模型后续的分析建立在这样被削弱逻辑关系的数据上,其结果的可靠性和正确性也难以衡量。出现这种问题的原因就在于,从大模型“看到页面”到“准确还原每个字段的归属”,中间还隔着一次结构还原。这正是合合信息文档解析工具TextIn xParse长期投入的方向——将复杂、大模型不易读懂的非结构化数据转为结构化数据,如此,大模型拿到的是结构关系明确的数据,才便于保证其后续分析结果的准确性。
结构保真,具体要保留哪些信息?
如前文所述,在交给大模型分析之前,先把非结构化文档还原成结构化数据——这正是使用大模型得到准确分析结果的核心前提。在解决“把非结构化数据转为结构化数据”这个问题上,合合信息TextIn xParse能够支持 PDF、Word、Excel、PPT、图片、HTML 等多种格式的解析,并按 Markdown 或 JSON 等格式输出;它把“版式不丢失、结构可还原、字段可溯源”当作三个工程目标,下面三项就是它对前述问题的具体回答。
阅读顺序:正文、批注与页眉不要混在一起
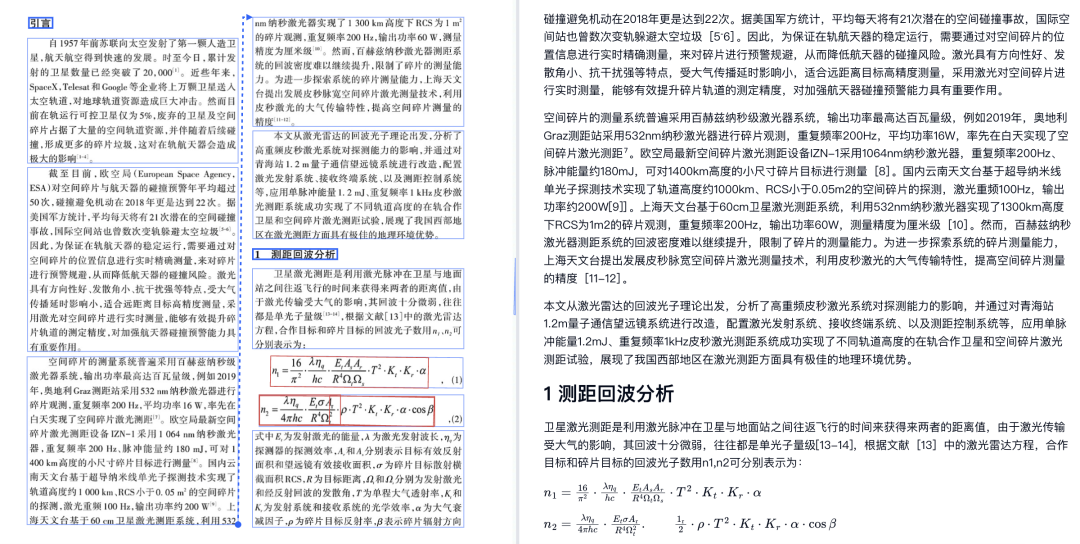
在阅读顺序上,合合信息TextIn xParse支持标题层级、文字段落及多栏阅读顺序的识别与还原,元素识别范围覆盖文本、表格、图片、页眉页脚、公式、印章、手写体、图表、脚注、水印等 16 类及以上内容。落到合同场景,正文、手写补充、批注与印章区域可以被分开呈现,审核时能分辨条款正文与后加的补充内容,页眉页脚也不会误入条款。
表格结构:数字必须回到正确的位置
在表格这一环,TextIn xParse可输出表格树与单元格几何属性,支持有线表、无线表、少线表、合并单元格表、跨页长表、嵌套表头与密集表格;针对金融年报、研报中的复杂表格还做了专项优化,表格可直接输出为 HTML 语法。在实际业务中,同一个“100”,在报价表里是数量还是单价,取决于它落在哪一列、归属哪一级表头——这些关系必须与数值一起保留下来。
字段溯源:定位原文位置,溯源保留证据
xParse 提供页面、段落、字符等层级的定位与溯源能力,JSON 输出可保留页码与 BBox 坐标。企业在文档解析之后做字段抽取时,把文件标识、原文页码、区域坐标和证据文本一并存下来,业务字段与解析结果之间就有了一条可回查的链路,复核与审计才有依据。
对接大模型、知识库和智能体,输出格式怎么选?
xParse的结构化输出可直接用于大语言模型、RAG和智能体场景。Markdown格式文档便于知识库搭建与大模型问答,适合承载连续阅读内容;JSON 保留结构、页码、BBox 与元数据,便于程序读取字段和位置;需要直接对接业务系统时,还可输出键值对形态。针对检索场景,xParse 额外提供搜索级分块与实体级分块,以及跨页段落合并、图片与注释关联等语义关系输出,让知识片段召回更准、上下文更完整。
工程侧也已打通常用生态:LangChain 插件 langchain-xparse、火山引擎 Coze、Dify、FastGPT、CherryStudio、RAGFlow,以及 MCP Server,接入方式贴合团队已有的技术栈。
识别率与解析速度,怎样看才不误判?
识别率与解析速度需要放在一起看。企业里的合同归档、财报入库对文档解析都是成批调用:只快不准,人工返工的成本会吃掉速度收益;只准不快,关账窗口和交付节点又会卡住。在识别率上,TextIn xParse对于常规印刷文字的识别率 99.77%,表格识别率超过 99%,复杂文档综合还原度 95%。在速度方面,xParse对于100 页长文档 PDF 在线解析快至 1.5 秒,在离线批量场景下,可一次性上传大量文档,能够做到 3 天完成 500 万页 PDF 解析。xParse服务日均支撑数百万级调用量,引擎支持 52 种以上语言的印刷体与手写体识别。xParse在算法上也做了深度调优,针对复杂版式持续优化,如此才让精度与速度在批量场景里同时成立。
关于最终效果,建议企业团队用自己的样本做一次测试:同一批文档、相同的任务要求,比较“直接把文件交给模型”和“先做文档解析、再交给模型”两条链路,重点记录字段准确率、结构正确率、证据完整率、复核工作量、端到端耗时。合合信息在选型阶段可以提供样本测试与接入支持,把口径对齐到真实文档上。
从 API 到私有化,如何接入现有系统?
接入方式上,合合信息文档解析提供云端 API(RESTful)与 SDK;也可以私有化部署在本地服务器或私有云,支持国产信创设备;面向扫描仪、扫描笔、摄像头等设备还提供端侧 SDK,让识别在硬件端实时完成。非技术团队可以先走 Web 端入口验证效果,再决定集成方案。
部署选型则围绕数据流向、访问权限、处理规模、网络条件和运维责任展开。对数据不出域要求较高的客户,私有化部署配合完整日志与错误追踪,可以满足内控与审计需要;产品侧内置图像篡改检测、印章检测与手写签名检测等风控能力,合合信息也已通过 ISO 27001、ISO 27701、CMMI Level 5 等体系认证。计费上以按量计费为主,私有化部署按项目规模与使用方式确定。
xParse进入业务流程,助力从人工翻录走向自动化入库
以某大型制造企业的采购合同业务为例,企业原先由员工逐页翻阅合同,手工录入供应商、物料、数量、单价、交付日期和付款条件。附件表格越长,核对负担越大;遇到跨页续表,还要反复确认表头和单位。
通过 API 接入合合信息xParse后,处理路径则是:先用xParse还原正文与附件表格的阅读顺序和行列关系,再由业务规则或大模型提取采购要素,把每一个字段关联到原文证据;对缺失值、日期冲突、金额不一致等情况设置复核规则,通过校验的结果再结构化入库。
预期效果上,xParse可以对复杂非结构化数据进行解析;依托其较高的常规印刷文字识别率,印刷体字段大部分可以直接进入校验环节,如此,人工录入工时便有望大幅下降,人工可以更多聚焦在异常核对环节,提升业务效率。
企业真正需要的,是可验证的文档处理链路
对于合同字段入库、复杂表格抽取和企业知识库建设,AI对PDF等复杂文档内容进行分析处理的结果优劣与否,很大程度上取决于原文内容是否忠实保留、结构是否正确恢复、字段是否有据可查。合合信息xParse把这三件事做成了可以逐项检查的产品能力,而不是寄希望于模型一次生成到位。
文档解析的价值,不是给模型加一道形式上的工序,而是先把非结构化文档整理成结构化数据,让大模型把精力放在分析解读上,而不是消耗在还原版式上。输入可检查,输出才可验证,这是更值得投入的工程方向。
如果正在评估文档解析方案,欢迎企业团队用自己的采购合同、年报或标书样本做一次实测,对照文档解析前后,模型分析的结果差异。
点击下方图片,了解更多合合信息TextIn xParse文档解析产品信息。