复杂表格识别为什么这么难?一篇讲透表格识别原理
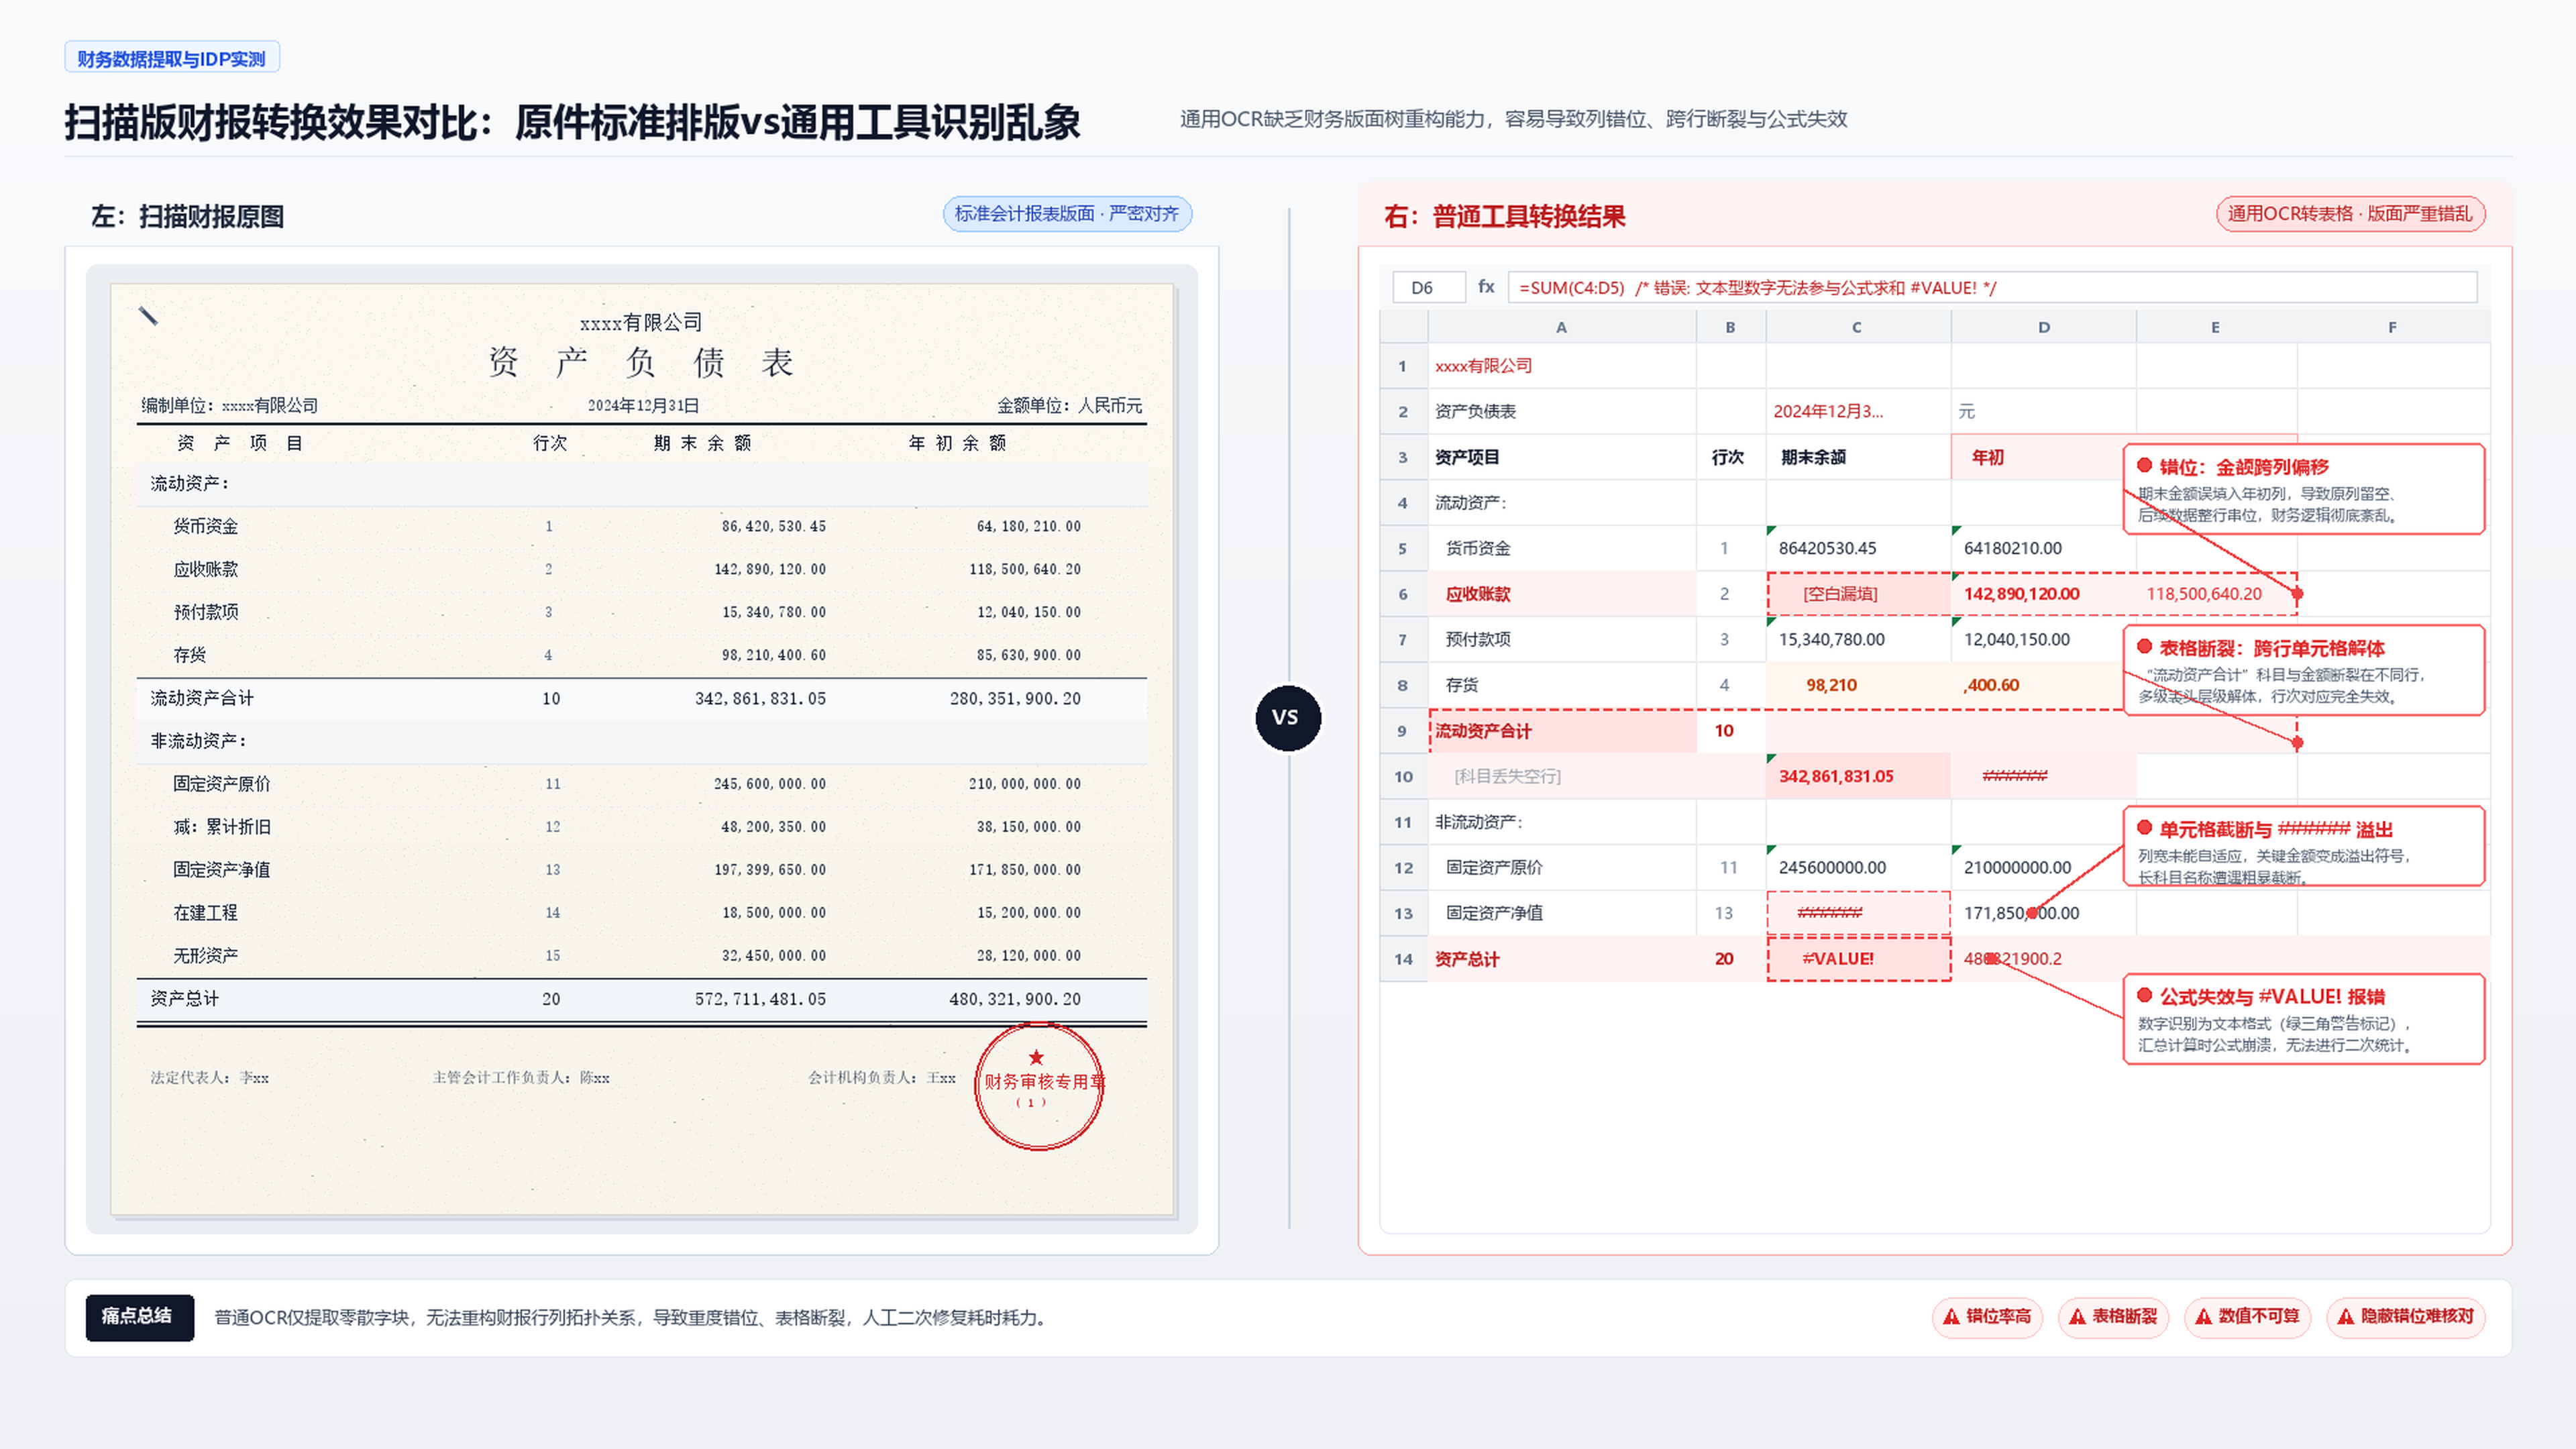
把一份扫描财报拖进普通转换工具,过了一会儿,Excel生成了。
虽然文字基本都在,但是合并单元格错了位,无线表格挤成了一列乱码,跨页表格也被从中截断。这样的结果看起来完成了转换,实际却无法直接使用。财务人员只能重新核对,甚至从头誊录。
问题到底出在哪里?
答案并不复杂:识别表格,真正难的不是“认字”,而是“还原结构”。
即使字符识别准确率很高,如果系统没有恢复行列关系、表头归属和单元格合并逻辑,那么输出结果仍然只是一堆缺少坐标关系的数据碎片。
2026年8月,国家知识产权局、国家数据局联合印发《关于加强知识产权数据资源开发利用的意见》,提出以释放数据要素价值为目标,加强数据资源开发利用,并推进人工智能等新技术在数据开发利用中的应用。但是在企业内部,大量高价值数据仍然藏在财报、标书、检测报告等表格密集型文档中,如果无法高质量提取这些表格,那么后续的数据治理、分析和复用就很难真正落地。
下面我们从表格识别原理切入,并说明复杂表格可以通过哪些技术路径完成结构还原。
为什么“字都认对了,表还是错的”?
传统OCR通常以“文本行”为输出单位,但是表格依赖的是二维结构。
比如,“营业收入”这四个字被准确识别出来,只代表文字识别成功。只有当系统知道它位于哪一行、哪一列,并且知道它归属于哪个表头时,这个单元格才具备业务含义。
如果表格没有明显边框线,那么系统就只能根据文字位置、间距和排列方式推断结构。如果表格中还存在跨行或跨列内容,那么合并单元格识别的难度还会继续增加。
企业文档中常见的复杂表格,大致可以分为六类:合并单元格表格、无线表格、跨页表格、带底色表格、密集表格、有线与无线混合型表格
财务报告、招投标文件和检测报告中的表格,通常都会命中其中一种,很多时候还会同时叠加多种情况。
所以,评价一套表格识别方案时,不能只看字符准确率,还要回答以下三个问题:
能不能推断表头?
能不能恢复单元格之间的行列关联?
能不能把分页或视觉断裂的结构重新接起来?
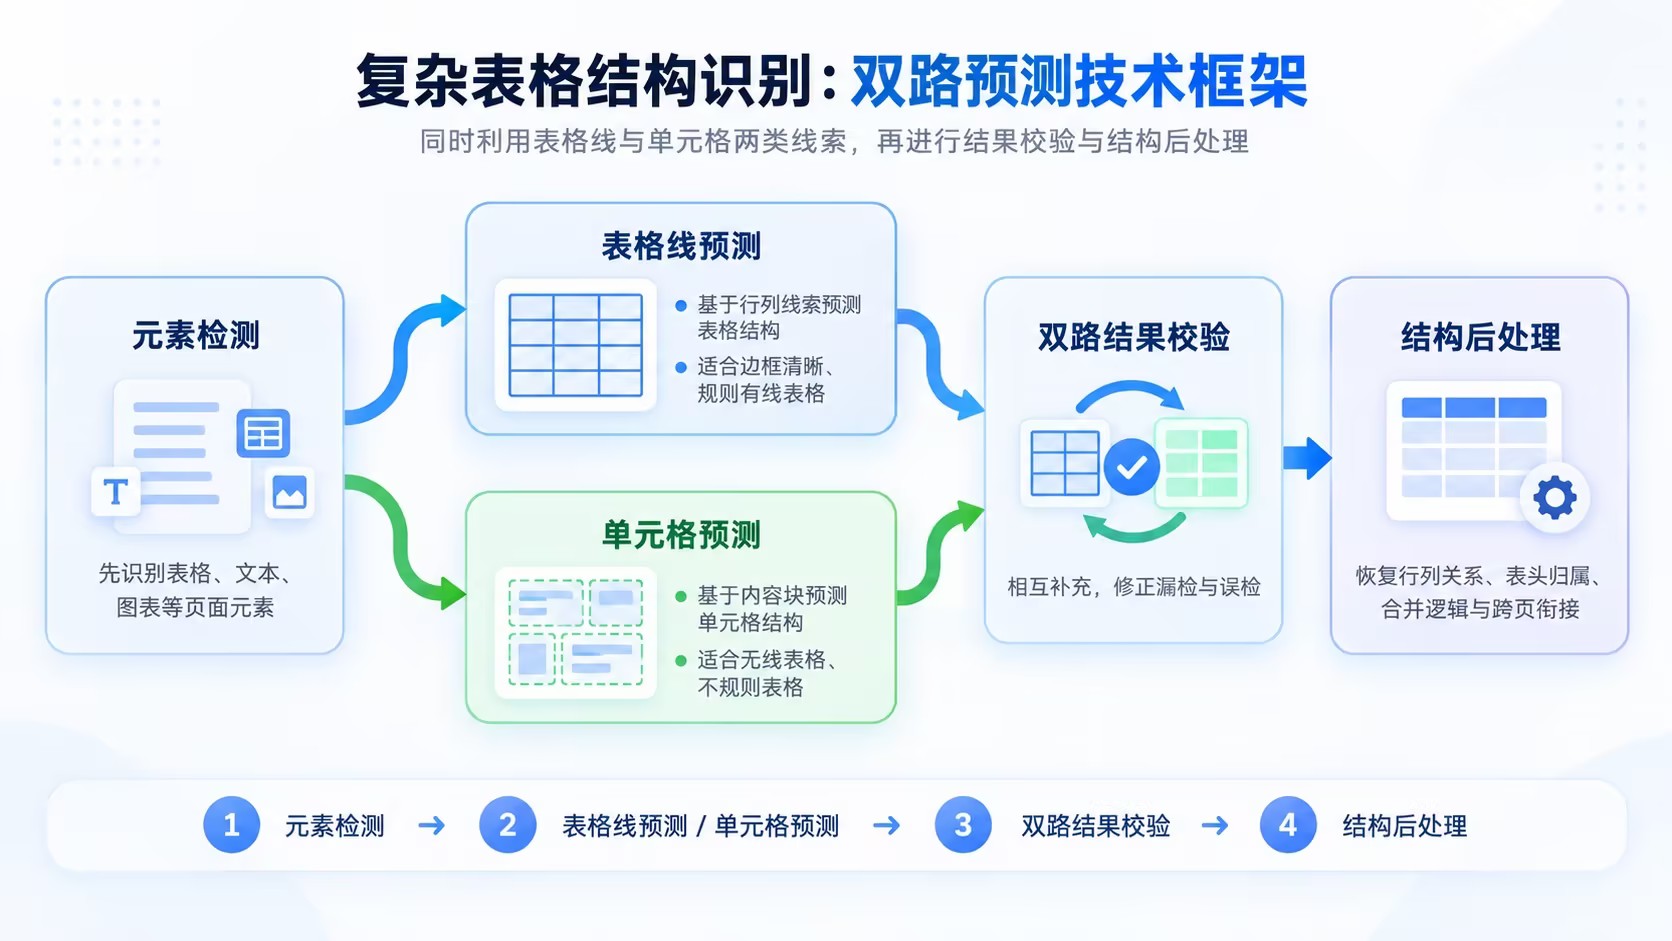
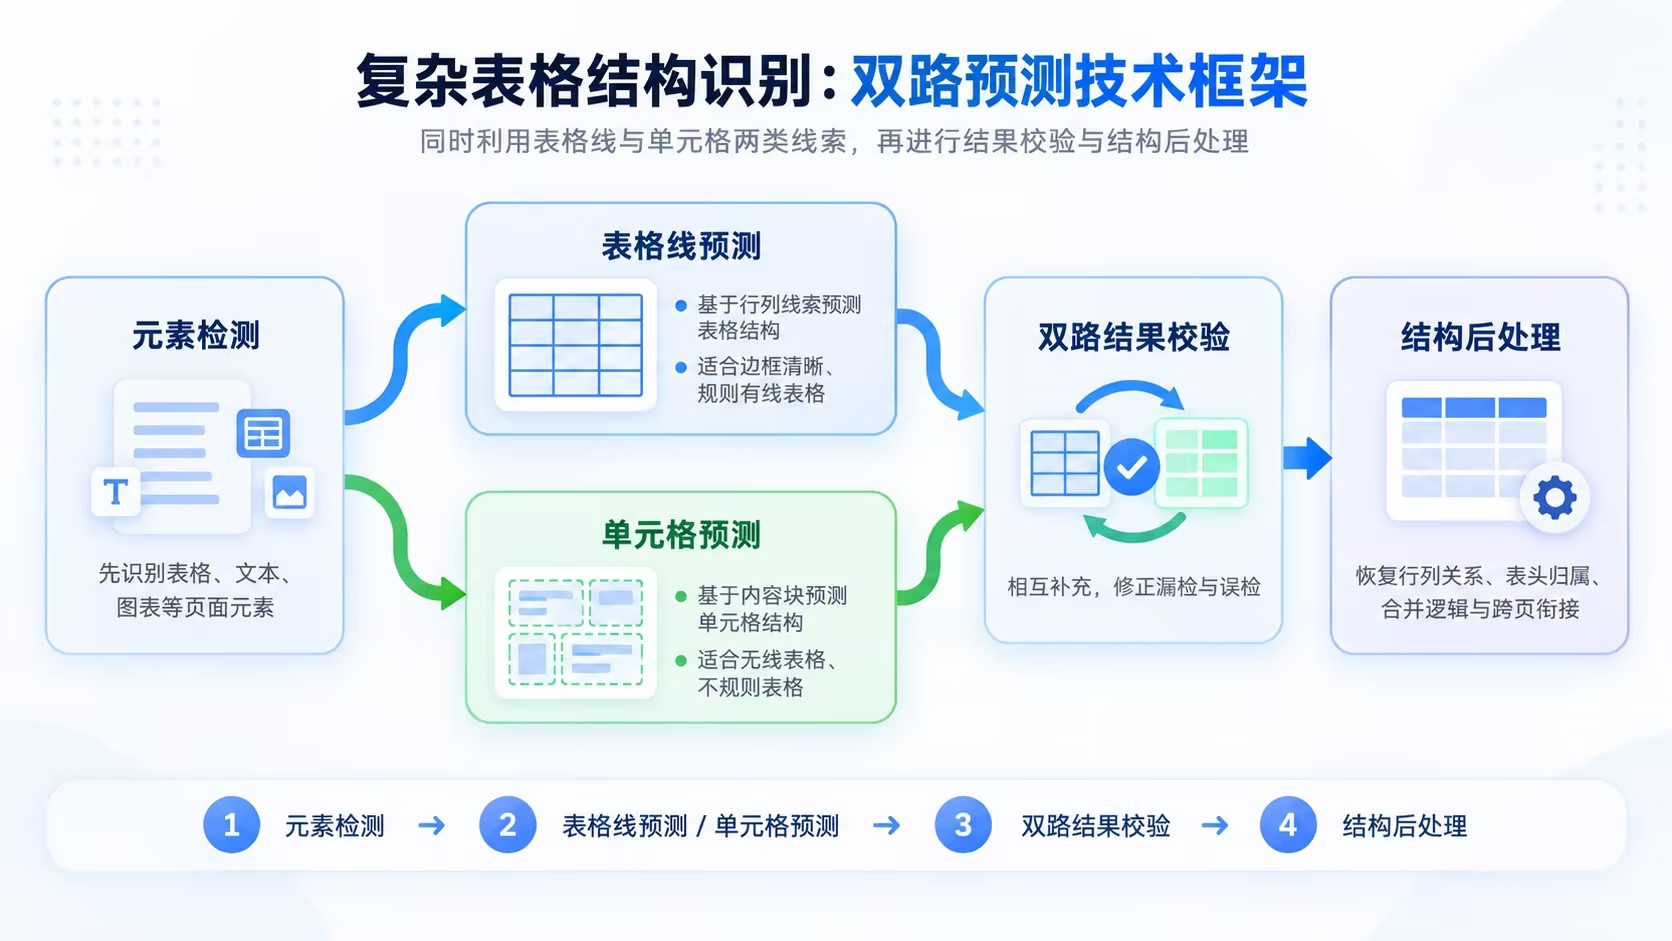
复杂表格到底如何完成结构检测?——“双路预测”
目前主流的表格识别原理主要有两条技术路线。
第一条路线从表格线入手。系统检测横线、竖线及其交点,再像划分棋盘一样确定单元格区域。
第二条路线从单元格入手。系统直接预测每个内容块的边界与归属,再根据单元格之间的位置关系反推出完整结构。
虽然两条路线都能完成表格解析,但是各自都有明显短板。
表格线预测适合边框完整、排列整齐的表格。因为横线和竖线清楚,所以系统可以快速确定单元格边界。但是如果进入无线表格识别场景,那么这条路线就缺少可依赖的视觉线索。
单元格预测更适合不规则表格和无线表格。因为系统不完全依赖边框,所以可以根据内容块的位置推断结构。但是当表格非常密集时,相邻单元格又可能被错误粘连。
因此,工程上通常不会在两条路线中二选一,而是同时处理:
元素检测 → 表格线预测与单元格预测 → 双路结果校验 → 结构后处理
有线表格可以优先参考表格线结果,无线表格和异形表格可以更多依赖单元格预测。然后,系统再对两路结果进行校验和补充。这样既能处理规则表格,又能提高复杂版式下的结构恢复能力。
合并单元格和跨页表格靠什么“接”回去?
合并单元格识别不只是检测一个更大的矩形框,还涉及语义关系判断。
比如,一个纵向合并单元格覆盖了下面三行数据。它的内容往往需要“广播”到对应的三行中,表示这些数据属于同一个类别。机器需要判断这是层级归属,而不是把下面的空白格当成内容缺失。
所以,合并单元格识别既需要版面检测,也需要结构和语义推断。
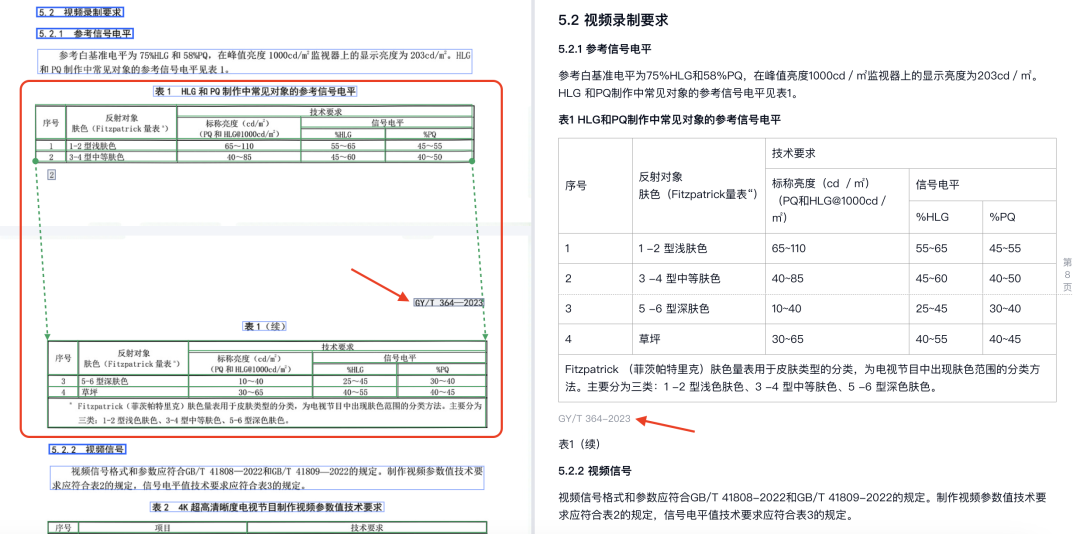
而跨页表格识别的情况更复杂。
例如,当一张财务报表的内容从文件第47页延伸到第48页时,两页之间不存在直接的视觉连接。系统只能通过前后页的结构特征判断它们是不是同一张逻辑表,这个时候,通常会比对以下信息:
前后两页的列数是否一致
表头及字段特征是否相近
各列的数据类型是否匹配
页面结尾与下一页开头是否存在连续关系
如果这些特征能够对应,那么系统就会进一步执行语义层级的后处理,把两段表格重新拼接起来。
如果跨页拼接没有做好,那么长文档里的核心数据表就会一直处于碎片状态,后续入库和分析也会随之受到影响。
表格识别原理落地后,实际效果怎么验证?
原理讲清楚后,最终还是要回到实际解析结果。
合合信息的TextIn xParse就是一款优秀的企业级文档解析、表格识别工具。其表格解析路径与上述框架一致:系统先通过统一的元素检测,区分页面中的表格、文本和图表;然后进入表格线预测、单元格预测及语义后处理环节;最终输出保留表头、行列关系和单元格关联的结构化数据。
所以,它输出的不只是图片或纯文本,还可以直接对接数据库和下游分析流程。
使用这类产品时,可以同时考察两个层面:
一是单元格文字能否被准确识别;二是表格逻辑能否被正确恢复,包括表头、数据区域、行列关系以及合并单元格的归属。
从多份复杂样本的测试体感看,无线表格识别和跨页表格拼接的稳定性,往往决定一套工具是“可以试用”,还是“可以进入生产流程”。
因此,如果团队正在做技术选型,最好不要只看标准演示Demo。直接找出业务中最难处理的三张表:一张无线表、一张合并单元格表,再加一张跨页表。跑完真实样本后,再看结构还原结果。
券商研报场景:表格数据如何直达估值模型?
以券商研究业务为例。研究团队每天需要处理数十份PDF研报,其中大量财务数据以无线表和密集表格的形式存在。如果依靠人工整理,不仅耗时,还容易在誊录环节引入错误,进而影响后续分析结论。
针对这个场景,可以通过API接入合合信息TextIn文档解析服务:系统自动识别研报中的表格内容,还原单元格之间的行列关系,并输出结构化结果,直接对接估值模型调用,省去人工录入环节。
表格数据的准确提取有助于后续分析,从效率上看,整体数据处理效率有望提升80%左右。研究员可以把更多时间投入到研究判断上,而不是数据搬运中。
接入方式与成本比想象中轻
对技术团队来说,落地门槛主要在集成方式。合合信息TextIn xParse提供多种接入形态:公有云API适合快速验证和弹性调用,私有化部署适合对数据安全有要求的集团型企业,端侧SDK则覆盖离线场景。性能方面,对于100页长文档的解析最快约1.5秒,批量离线处理可在3天内完成500万页PDF解析。这个量级,支撑大多数企业的存量文档治理需求,问题不大。
付费采用按量计费,企业可以根据自身业务量选择合适的合作模式。如果团队有引入计划,务实的路径是先预约产品演示,直观了解解析和抽取的实际效果;确认匹配后,再拿自己真实的扫描件、跨页表、合并单元格样本进入POC测试,用解析准确率和结构还原度说话,最后再评估是否扩大接入。
表格识别原理并不神秘,但要做到生产可用,检测、推断、拼接、泛化,每个环节都得下笨功夫。如果你的团队正被复杂表格卡住数据入口,不妨从一次真实样本的实测开始。👇
点击下方图片,了解更多合合信息智能文档解析产品的相关信息。